帰無仮説と対立仮説の違いは?なぜ主張を対立に置くのか徹底解説
データサイエンスやビジネスにおけるデータ分析の重要性が高まるなか、統計検定2級の受験者や実務の初学者が必ず直面する最大の難所が「仮説検定」のロジックです。とりわけ「なぜ自分が証明したい主張を直接証明せず、あえて否定したい仮説を立てるのか」という思考プロセスは、直感に反するため多くの学習者を悩ませています。
本稿では、統計学の土台となる帰無仮説(きむかせつ)と対立仮説(たいりつかせつ)の本質的な違いをはじめ、検定の判断基準となるp値や有意水準の仕組み、現場で頻出する過誤のリスクまで、具体例とともに分かりやすく紐解きます。
📌 【この記事の重要ポイントまとめ】
- 要点1:帰無仮説は「差がない・効果がない」とする仮説であり、証明したい本命の主張は必ず「対立仮説」に設定する。
- 要点2:証明したい主張を直接立証するのではなく、「差がない」という仮説が確率的に極めて珍しい(有意水準5%未満など)と示すことで間接的に退ける「背理法」の論理を採用している。
- 要点3:帰無仮説が棄却できなかった場合でも「帰無仮説が正しいと証明されたわけではない(保留)」という実務上の重大な落とし穴に注意が必要である。
【基本概念】帰無仮説と対立仮説の違いとは?なぜ証明したい主張を「対立」に置くのか
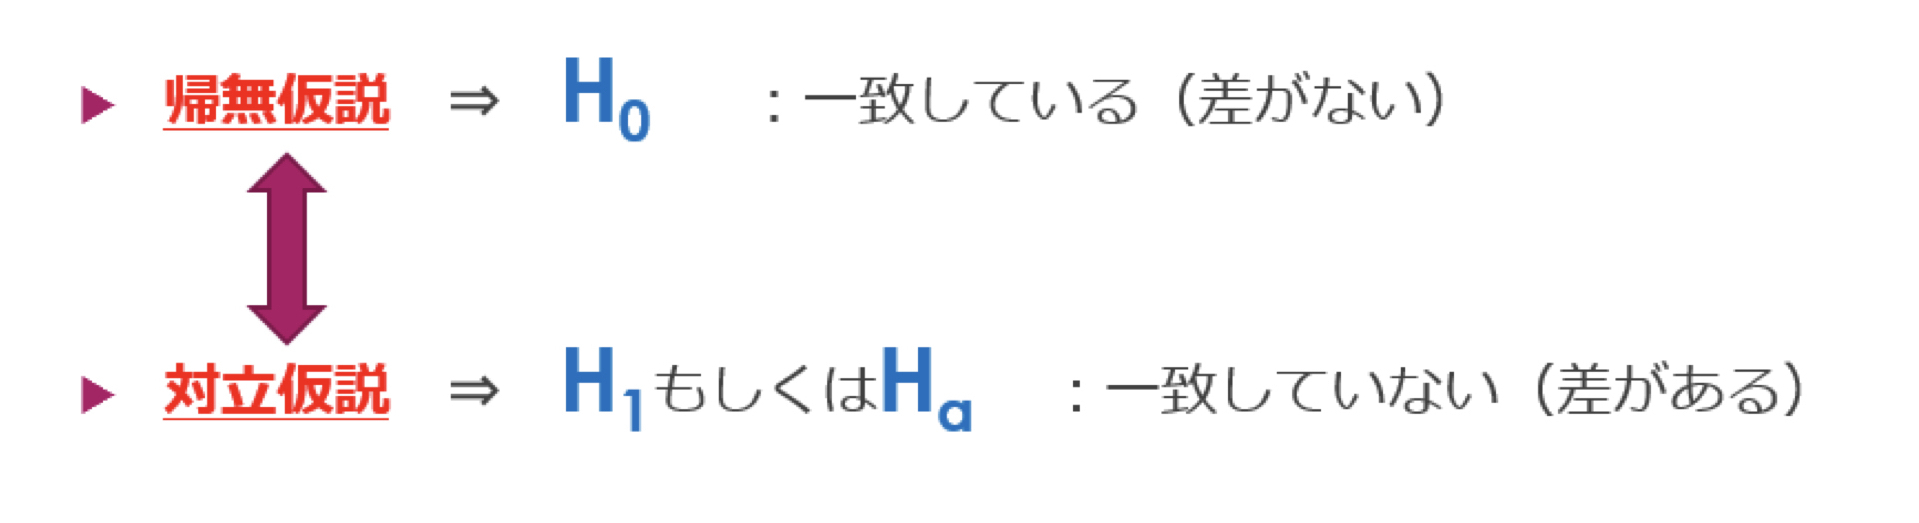
統計的仮説検定において、最初に立てる2つの仮説が帰無仮説($H_0$)と対立仮説($H_1$)です。両者の役割は明確に分かれています。
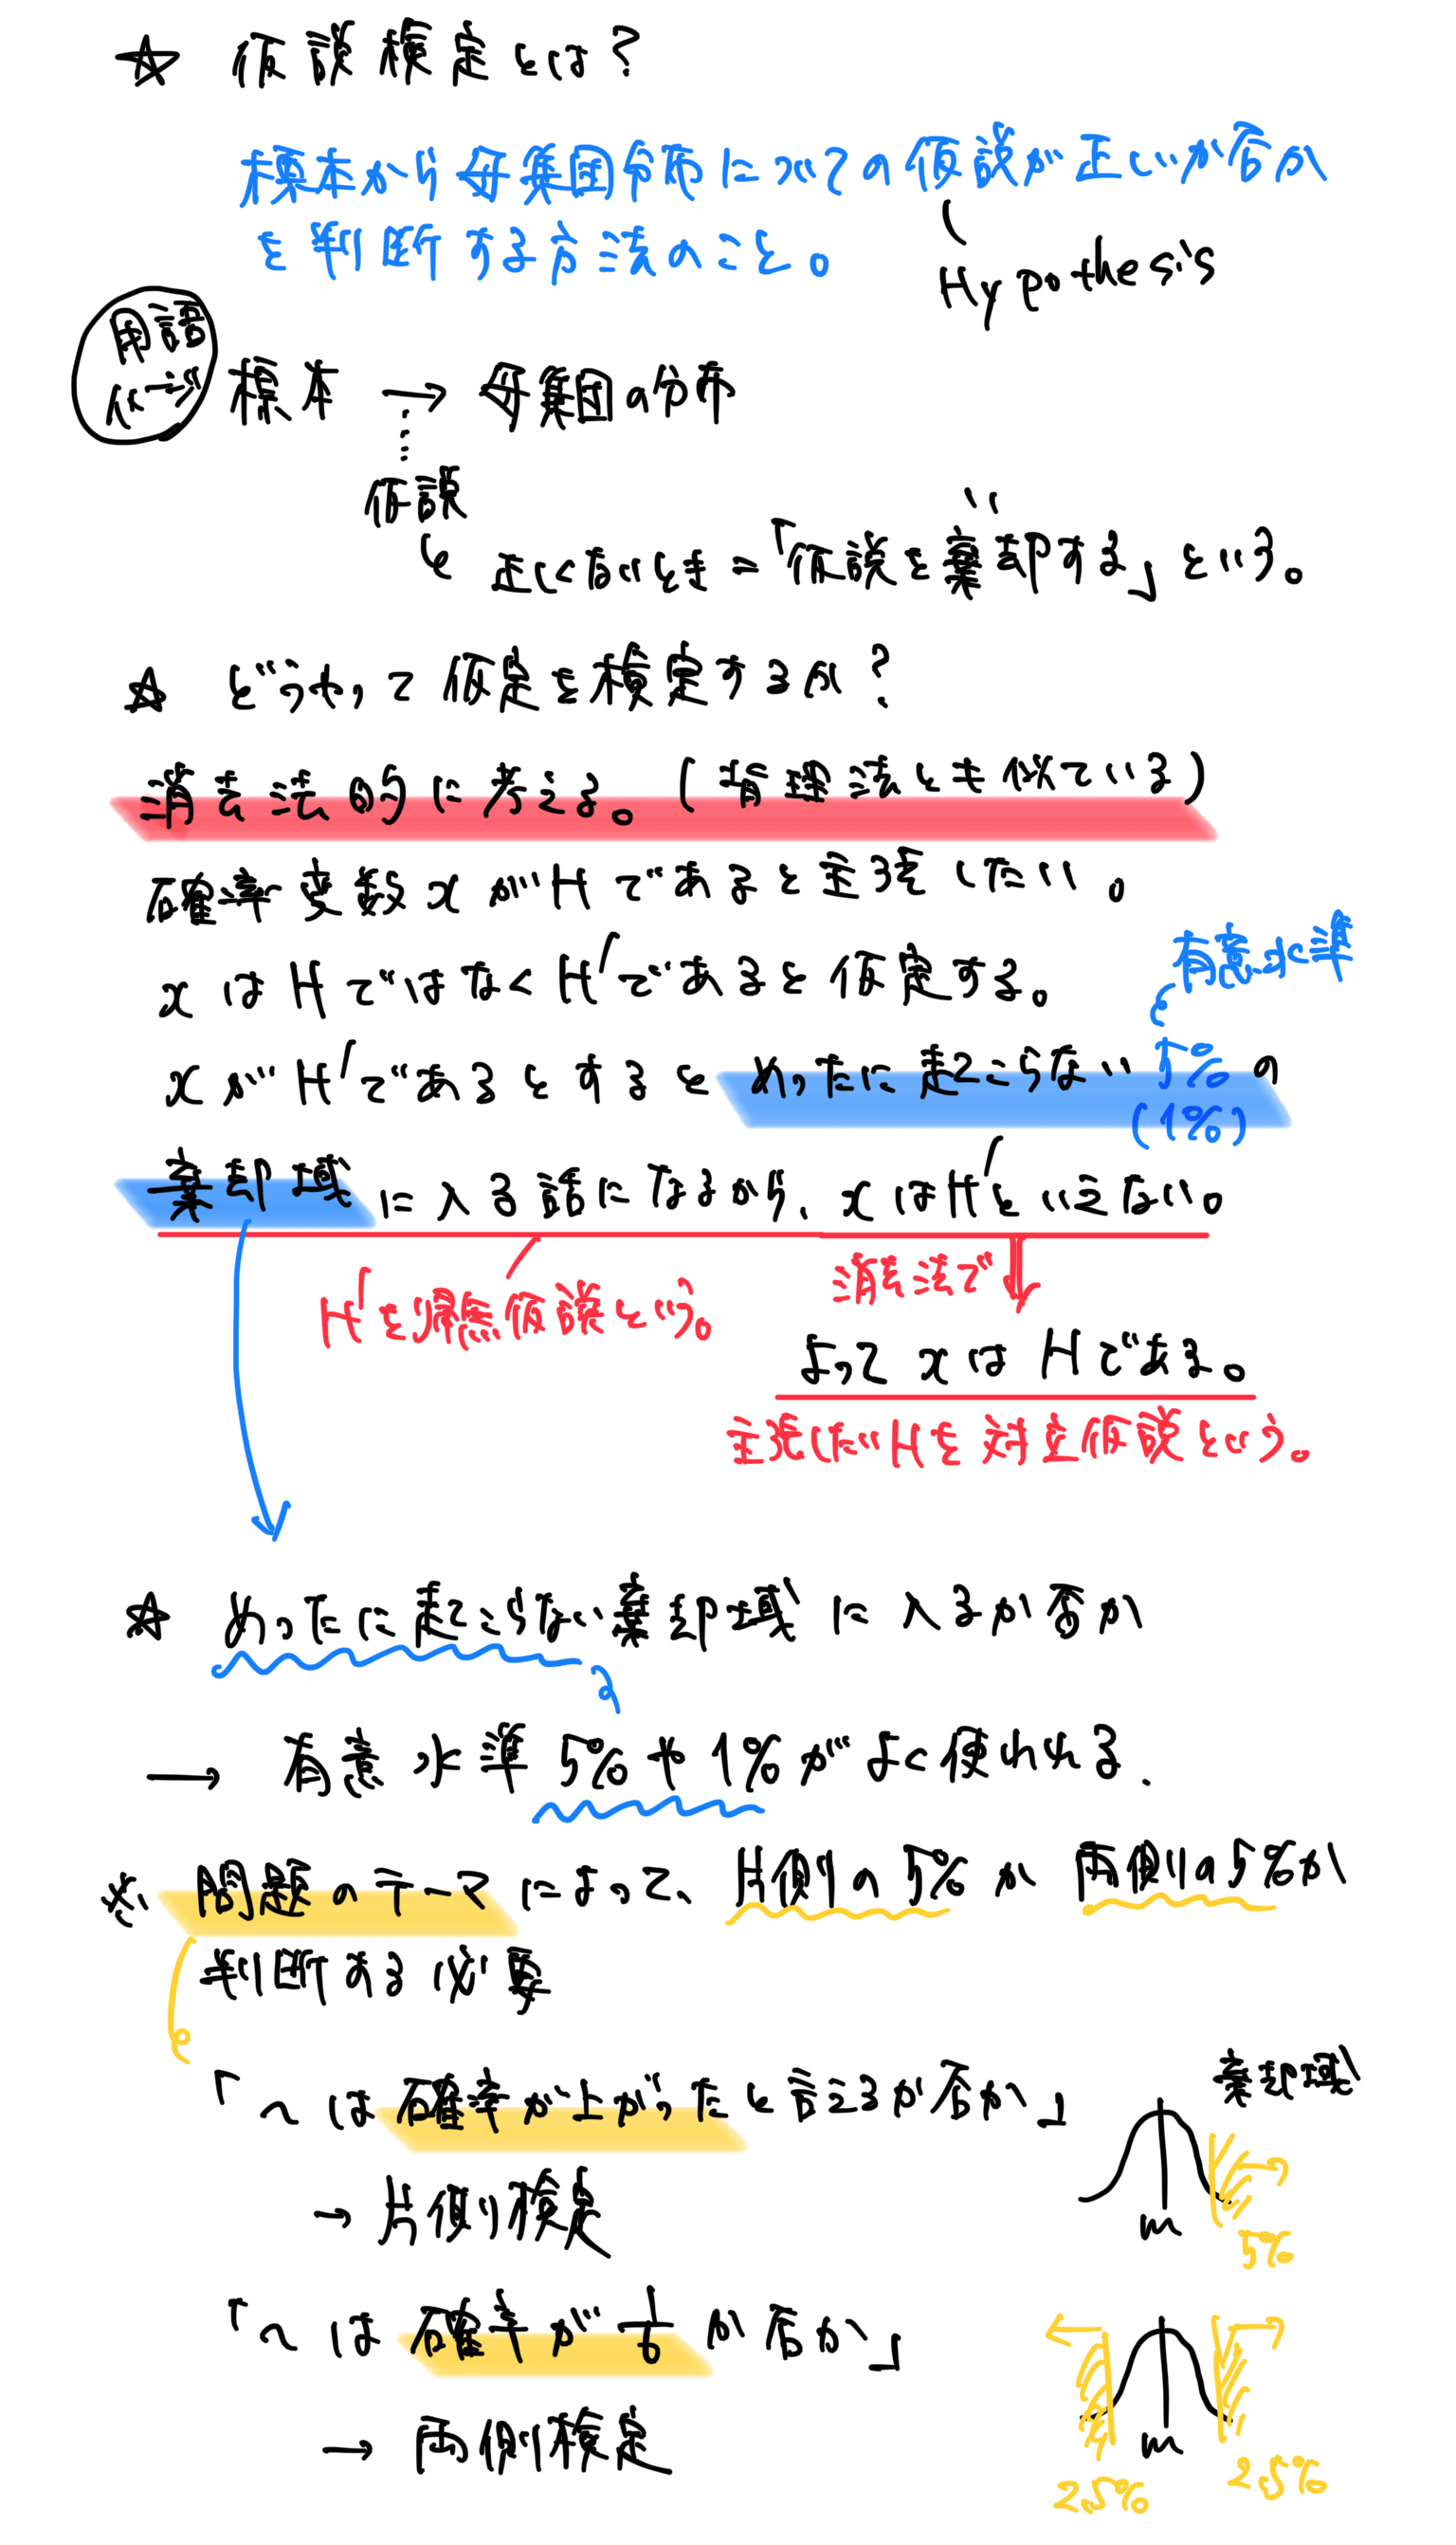
帰無仮説(Null Hypothesis: $H_0$)は、「無に帰する」という文字通り、最終的に否定(棄却)されることを目的に立てる仮説です。具体的には「新薬と従来薬で効果に差がない」「WebサイトのUIを変更してもコンバージョン率に差はない」といった、「効果や差が存在しない」状態を前提とします。
一方、対立仮説(Alternative Hypothesis: $H_1$)は、帰無仮説に対立する主張であり、分析者が本当に証明したい本命の仮説です。「新薬には従来薬より高い効果がある」「新しいUIのほうがコンバージョン率が高い」という主張がこれに該当します。
では、なぜ最初から「新薬には効果がある」という仮説を直接証明しようとしないのでしょうか。その決定的な理由は、統計学における「悪魔の証明」を回避するためです。
「新薬に効果がある」という主張を直接証明するには、効果の大きさが「1%なのか、5%なのか、それとも10%なのか」という無限の可能性をすべて検証しなければならず、基準となる確率分布を特定できません。しかし、「効果の差はゼロである(効果がない)」と仮定すれば、「差が0」を中心とした正規分布やt分布といった明確な確率分布を1つに固定できます。
明確な基準を作ったうえで、「もし効果がゼロだと仮定したら、今回得られたデータのような偏りが生じる確率はどれくらいか?」を計算します。その確率があまりにも低ければ、「差がゼロという前提自体に無理があった」と結論づけて帰無仮説を捨て去り(棄却)、対立仮説を採る(採択)という論理展開を用います。これは数学の「背理法」と全く同じアプローチです。
【早見表】仮説検定の全体像と主要パラメーターの比較
統計的仮説検定を正しく理解し、統計検定2級などの試験対策や実務で迷わないためには、登場する専門用語の関係性を整理しておく必要があります。以下の比較表で全体像を確認しましょう。
| 項目 | 詳細・数値データ | 一般的な基準・相場 | 編集部の見解・評価 |
|---|---|---|---|
| 帰無仮説($H_0$) | 「効果がない」「差がない」とする否定対象の仮説 | イコール(=)を含む等式で設定 | 検証の足場を作るための前提条件。棄却されることを前提に設計する。 |
| 対立仮説($H_1$) | 分析者が実際に主張・証明したい本命の仮説 | ノットイコール(≠)や不等号(>、<)で設定 | ビジネスの施策効果や学術的発見の根拠となる中核要素。 |
| 有意水準($\alpha$) | 帰無仮説が正しいのに誤って棄却してしまう許容確率 | 5パーセント(0.05)または1パーセント(0.01) | 慣例として5%が使われるが、医療現場など人命に関わる場合は1%以下に厳格化される。 |
| p値(有意確率) | 帰無仮説の前提下で、観測データ以上に極端な結果が出る確率 | 0〜1の連続値(実測データから算出) | p値 < 有意水準のときに帰無仮説を棄却。小さければ小さいほど「偶然とは考えにくい」ことを示す。 |
| 検定の方向性 | 両側検定(差があるか)/片側検定(大小関係があるか) | 探索的分析は両側、事前の理論的根拠がある場合は片側 | 安易な片側検定の選択は恣意性とみなされるため、原則は両側検定が標準。 |
【ステップ解説】有意差を導く仮説検定の正しい手順と具体例
実際にデータから有意差を判断するまでの流れは、厳密なルールに従って進められます。ここでは、実務や試験で最も頻出する「2群の平均値の差を比べるt検定」を具体例に、4つのステップで手順を追っていきます。
【検証シナリオ】
あるECサイトで、従来の広告文Aと新しい広告文Bのクリック率(または平均購入単価)を比較する。新広告Bのほうが平均購入単価が高いことを証明したい。
ステップ1:仮説の設定(仮説の立て方)
- 帰無仮説($H_0$):新広告Bと従来広告Aの平均購入単価には差がない($\mu_B - \mu_A = 0$)
- 対立仮説($H_1$):新広告Bと従来広告Aの平均購入単価には差がある($\mu_B - \mu_A \neq 0$)※両側検定の場合
ステップ2:有意水準($\alpha$)と棄却域の決定
分析を始める前に、偶然とは言えない基準となる有意水準を5パーセント($\alpha = 0.05$)に設定します。有意水準5%の両側検定の場合、確率分布の両端あわせて5%(片側2.5%ずつ)の領域が棄却域となります。
ステップ3:検定統計量の算出
収集したサンプルデータから、平均値、標準偏差、サンプルサイズを用いてt値を算出します。t値とは「データの差が、サンプルのばらつき(標準誤差)の何倍離れているか」を示す指標です。
ステップ4:p値の算出と判定(棄却か受容か)
算出したt値からp値を求めます。
- p値 < 0.05 の場合:「差がない」という前提では5%未満の極めて稀な現象が起きたと判断し、帰無仮説を棄却して対立仮説を採択します。「統計的に有意な差がある(有意差あり)」と結論づけます。
- p値 $\ge$ 0.05 の場合:「差がない」という前提でも起こりうる誤差の範囲内であるため、帰無仮説を棄却できない(採択・受容)と判断します。「有意な差があるとは言えない」という結論になります。
【実態検証】統計検定2級の受験者と実務者が直面する「リアルな落とし穴」
データ分析の現場や資格試験の学習コミュニティを調査すると、仮説検定の解釈に関して特定の誤解が繰り返し発生している実態が浮かび上がります。
落とし穴1:「帰無仮説を棄却できない=帰無仮説が正しい」という致命的な勘違い
最も多い間違いが、検定の結果「p値が0.05以上だったから、帰無仮説(差がない)が正しいと証明された」と解釈してしまうことです。
統計学における「棄却できない」という状態は、単に「手元のデータ数が少なすぎるなどの理由で、差がある証拠を掴みきれなかった」に過ぎません。裁判に例えるなら、「証拠不十分で無罪(クロと証明できない)」になった状態であり、「完全にシロ(潔白)であると証明された」わけではないのです。そのため、学術的には「帰無仮説を受容する」と言っても「帰無仮説が真であると証明された」とは決して主張しません。
落とし穴2:都合よく片側検定を選んでしまう「p-hacking(有意性操作)」
両側検定ではp値が0.07で有意にならなかったデータに対して、「新広告のほうが良いに決まっているから片側検定に変えよう」と変更し、p値を半分(0.035)にして「有意差が出た」と発表するケースが散見されます。しかし、事後的に検定方法を変更する行為はデータの恣意的な改ざんとみなされ、学術界や厳格なビジネス分析では厳重に禁止されています。
【リスク管理】第1種の過誤と第2種の過誤|ビジネスと研究で絶対に防ぐべき失敗
仮説検定は確率に基づいた推論である以上、100%の正解を保証するものではありません。必ず一定の確率で「誤った判断」を下すリスクが伴います。この誤りを第1種の過誤と第2種の過誤と呼びます。
第1種の過誤($\alpha$エラー / 偽陽性: False Positive)
実際には「差がない」のに、誤って帰無仮説を棄却し「差がある」と判断してしまう誤りです。効果のない新薬を「効果がある」と誤認して承認してしまう、まったく効果のない新機能を「改善された」と誤信してリリースしてしまうリスクがこれに当たります。この誤りを犯す上限確率が「有意水準 $\alpha$(通常5%)」です。
第2種の過誤($\beta$エラー / 偽陰性: False Negative)
実際には「差がある」のに、帰無仮説を棄却できず「差がない」と見逃してしまう誤りです。真に有効な新薬を「効果なし」として開発中止にしてしまう、優れた施策を「数値差がない」と見捨ててしまう機会損失のリスクです。
第1種の過誤を起こす確率($\alpha$)を小さくしようと有意水準を厳しく(例: 1%)すると、逆に第2種の過誤を起こす確率($\beta$)が高くなるというトレードオフの関係が存在します。実務では、どちらの誤りがより深刻な損害をもたらすかを考慮し、サンプルサイズ($n$数)を十分に確保して検出力($1-\beta$)を80%以上に高める設計が求められます。
【誤解を是正】「p値が小さい=効果が大きい」ではない?統計的有意と実質的有意の罠
実務において最も警戒すべき盲点が、「統計的有意(Statistically Significant)」と「実質的有意(Practically Significant)」の混同です。
仮説検定の計算式上、サンプルサイズ(データ数)を数十万〜数百万件に増やすと、どんなに微小な差であってもp値は0.001を下回り、統計的に有意になります。例えば、ECサイトの購入単価が「10,000円」から「10,005円」へとわずか5円上昇しただけでも、データ数が膨大であれば「有意差あり(p < 0.01)」という結果が出てしまいます。
しかし、ビジネス上「5円の差」に多額の開発コストをかける価値があるでしょうか。これが統計的有意であっても実質的意味を持たない状態です。現代のデータ分析では、単にp値だけで判断するのではなく、差の絶対的な大きさを表す効果量(Effect Size / Cohen's dなど)や信頼区間を併せて報告することが国際的な標準となっています。
【現場の判断基準】統計的仮説検定を活用すべき人・注意が必要な人の特徴
✅ 積極的に活用すべき人・場面:
- 施策のA/Bテストを実施し、サンプルの偶然の偏りによる判断ミスを排除したいマーケター
- 治験データや製造ラインの品質管理で、厳密な基準に基づいて差異を立証したい研究開発者
- 統計検定2級・準1級の合格を目指し、数理的背景に基づいた論理的思考力を身につけたい学習者
⚠️ 取り扱いに注意が必要な人・場面:
- サンプルサイズが極端に小さい(各群10件未満など)状態で、無理に白黒をつけようとしている人(第2種の過誤のリスクが極大化)
- 数百万件のビッグデータを扱い、p値の小ささだけで「大成功だ」と短絡的に結論づけがちな人(効果量の確認が不可欠)
【帰無仮説・対立仮説】に関するよくある質問(FAQ)
Q1:帰無仮説は必ず「差がない」「効果がない」としなければいけませんか?
A1:原則として「差がない($\mu_1 - \mu_2 = 0$)」と設定するのが標準ですが、応用的な検定では「新薬の効果が従来薬より少なくとも5点以上高い($\mu_1 - \mu_2 \le 5$)」といった特定の基準値を帰無仮説に設定する「非劣性検定」や「同等性検定」も存在します。初学者の段階ではまず「差がない=ゼロ」とする基本形を確実に押さえましょう。
Q2:なぜ有意水準は「5パーセント」が標準なのですか?
A2:近代統計学の父と呼ばれるロナルド・フィッシャーが著書の中で「20回に1回(5%)起こるような珍しい事象を基準にするのが便利である」と言及したことが慣例化したものです。理論的な絶対値ではなく歴史的な目安ですが、現在も多くの学術論文やビジネスの現場で5%(あるいはより厳格な1%)がデファクトスタンダードとして採用されています。
Q3:統計検定2級の対策として、帰無仮説・対立仮説はどこまで理解が必要ですか?
A3:統計検定2級では、問題文のシチュエーションから「適切な帰無仮説と対立仮説(両側か片側か)を立式できるか」「正規分布表やt分布表から棄却域の境界値を読み取れるか」「p値と有意水準を比較して正しい結論を選択できるか」が頻出します。計算手順だけでなく、第1種・第2種の過誤の定義を含めた論理構造を正確に言語化できるようにしておくことが合格への近道です。
まとめ:仮説検定の論理を味方につけて精度の高い意思決定を
帰無仮説と対立仮説を用いた「仮説検定」は、直感や経験則に頼りがちなビジネスや研究の現場において、データの客観的な裏付けを与える極めて強力な武器です。
「証明したい本命があるからこそ、あえて逆の『差がない仮説』を立てて背理法で崩す」という統計的思考の神髄を掴めば、p値の読み間違いや過誤のリスクを未然に防ぐことができます。単なる用語の暗記にとどまらず、その背景にある確率的なロジックを理解し、実務や資格取得に向けた確かなデータリテラシーとして役立ててください。 (出典: 帰 無 仮説 対立 仮説(Yahoo!ニュース))

Webメディアの編集およびコンテンツ作成に従事。正確で質の高い情報発信を心掛けています。