分散とは?統計学の基本から標準偏差との違い・計算式まで徹底解説
ビジネスの現場やデータ分析、さらには資産運用において「平均値」だけを見て判断を下し、思わぬ失敗を喫するケースが後を絶ちません。平均値が同じであっても、データ全体の散らばり方が異なれば、リスクや実態は全くの別物になります。そこで不可欠となるのが、データのばらつき度合いを客観的な数値で把握する「分散」の概念です。
本記事では、統計学の基礎知識である分散の意味や求め方の公式、現場で混同されやすい標準偏差との違いを分かりやすく紐解きます。実務で役立つエクセルの関数使い分けから、金融における分散投資のメリットまで、データリテラシーを高める必須知識を網羅的にお届けします。
📌 【この記事の重要ポイントまとめ】
- 要点1:分散とは「データが平均値からどれくらい散らばっているか」を二乗の平均で数値化した統計指標。
- 要点2:平方根を取った「標準偏差」と組み合わせることで、元のデータと同じ単位でばらつきを直感的に把握できる。
- 要点3:エクセルでは標本データなら
VAR.S、全数データならVAR.Pを使い分けるのが鉄則。
【基本概念】分散とは何か?データのばらつき度合いを可視化する統計学の基礎知識
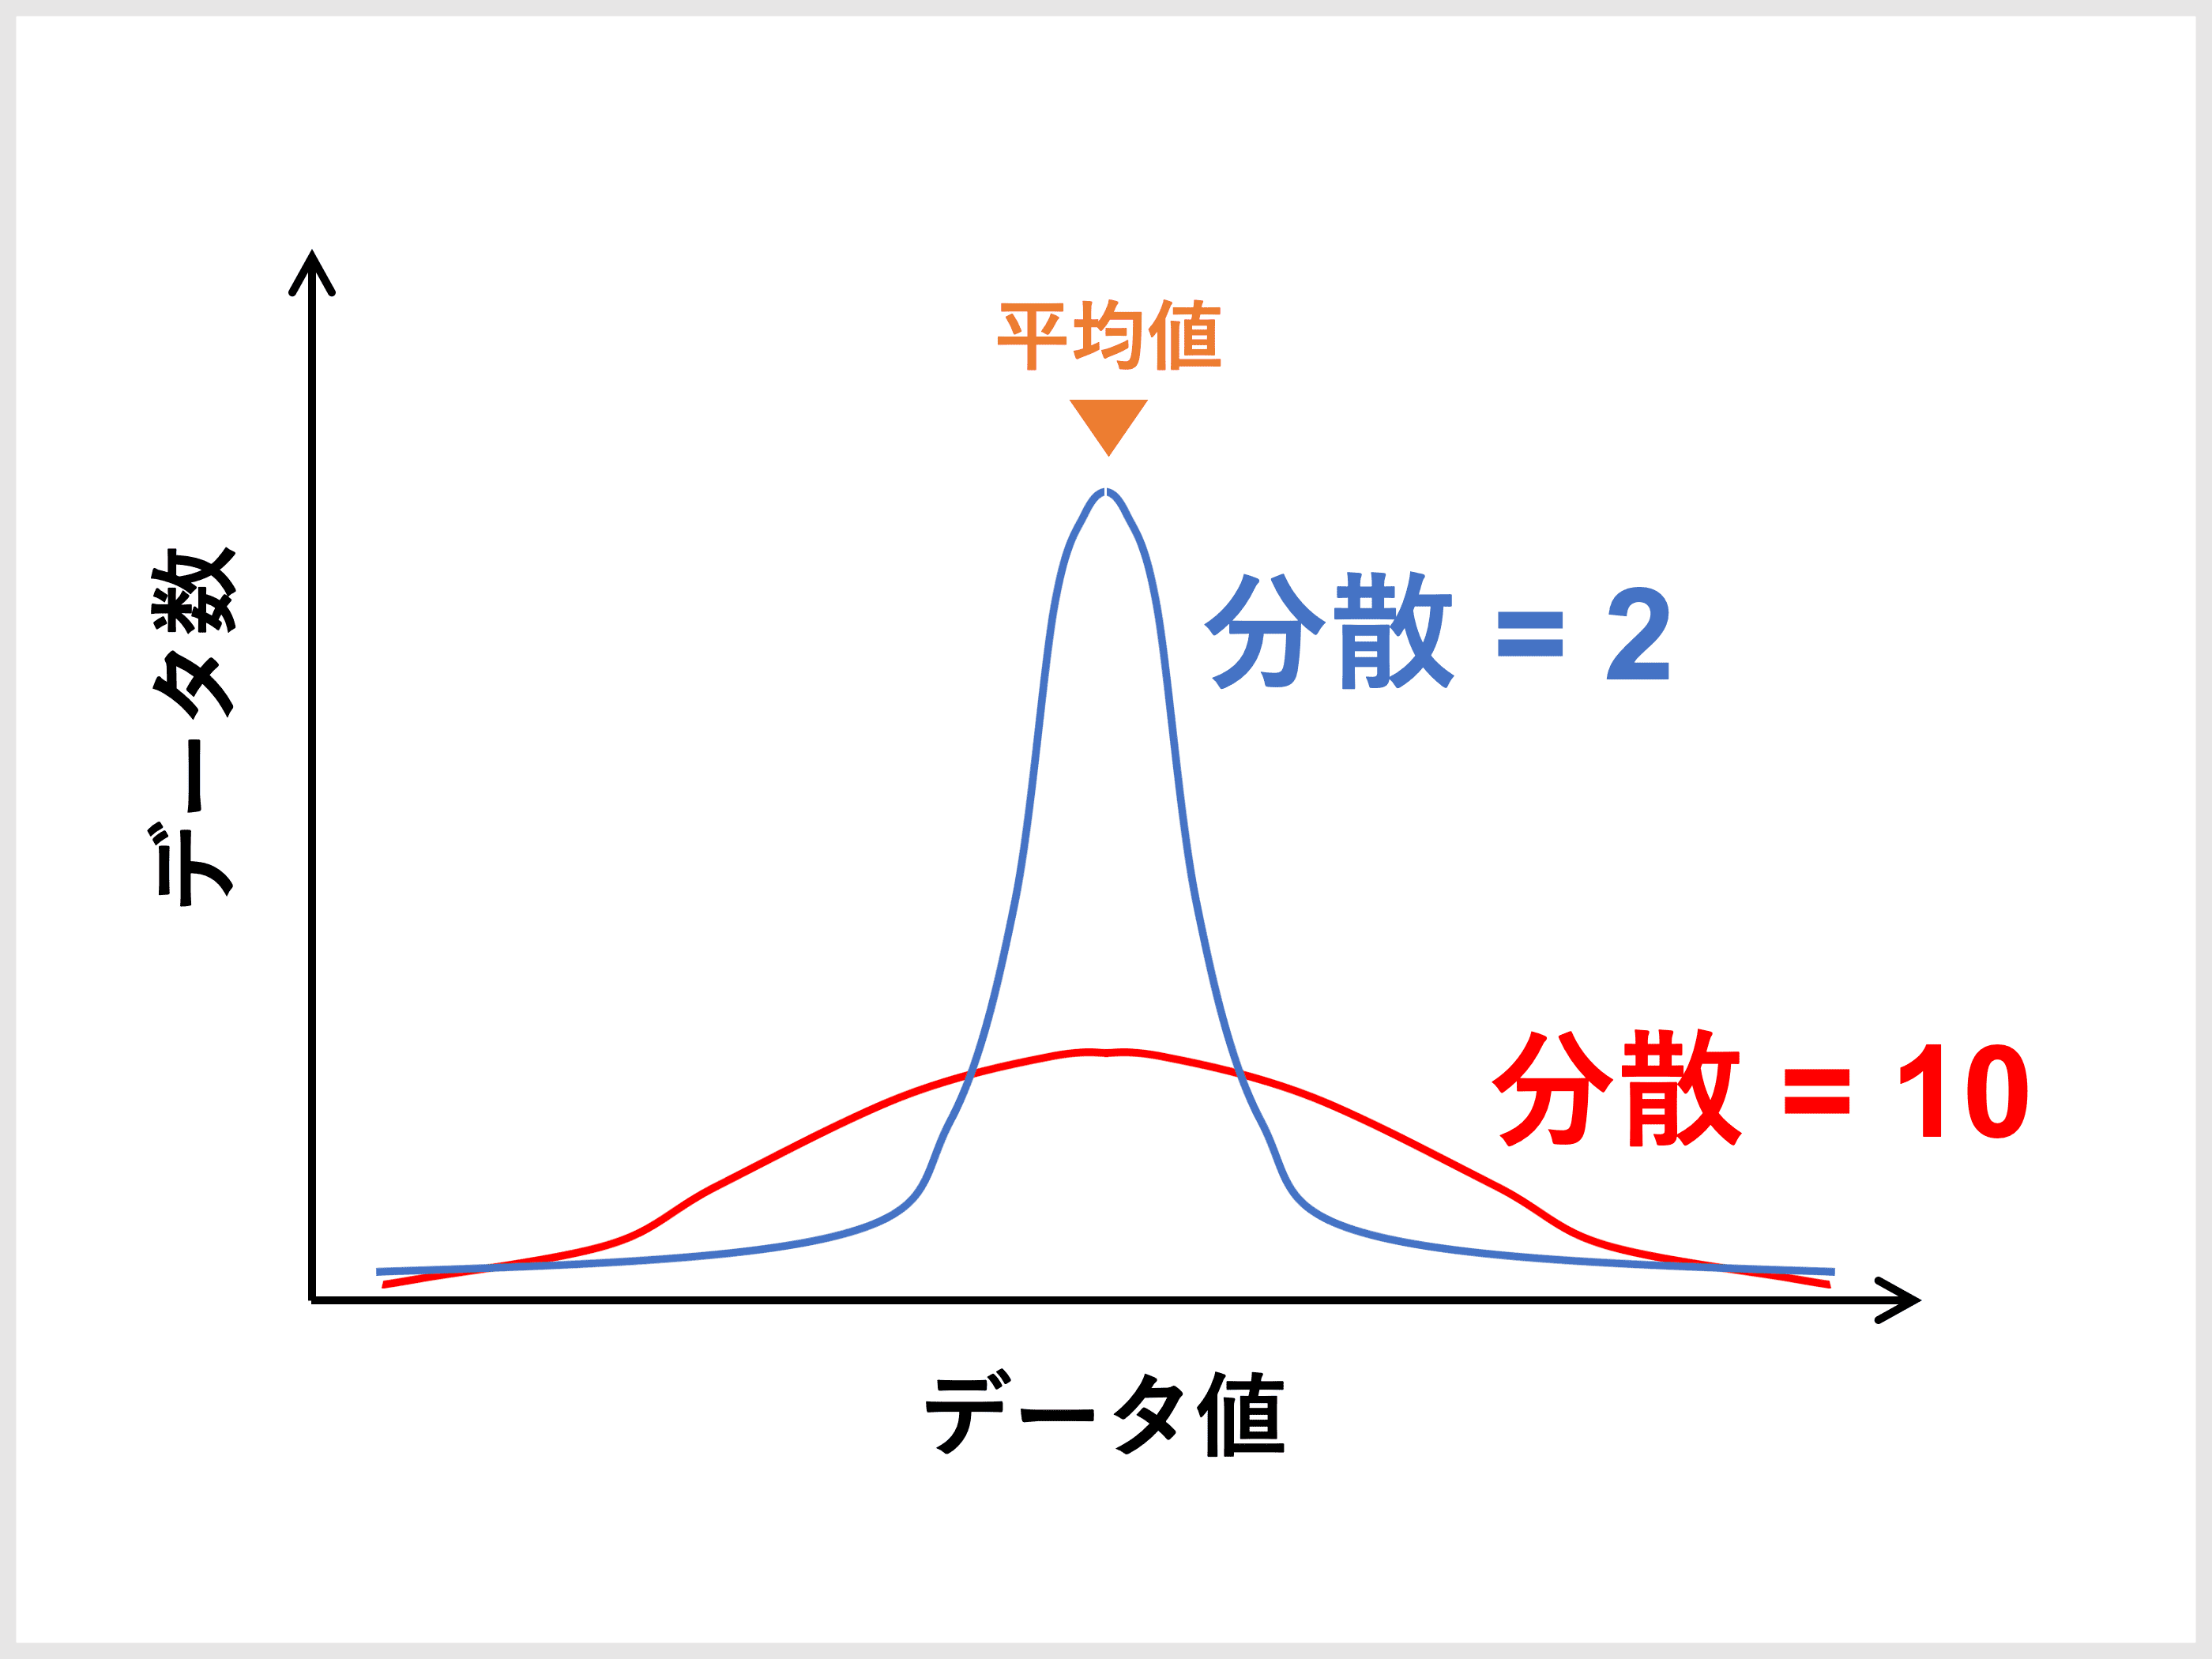
分散を一言で表すと、「各データが平均値からどれほど離れているかを示す散らばりの尺度」です。確率統計の基礎において、データの中心的な位置を示す代表値として平均値と中央値がよく使われますが、中心値だけでは全体の分布形状までは見えてきません。
例えば、あるIT企業における2つの部署(Aチーム・Bチーム、各5名)の月間残業時間を比較してみましょう。
- Aチーム:18時間、19時間、20時間、21時間、22時間(平均:20時間)
- Bチーム:0時間、5時間、20時間、35時間、40時間(平均:20時間)
どちらのチームも平均残業時間は「20時間」で全く同一です。しかし、実態は大きく異なります。Aチームは全員が満遍なく20時間前後の業務量をこなしているのに対し、Bチームは特定の人員に過度な業務負荷が集中しています。このような「偏り」や「ばらつき」を明確な数値として炙り出すツールこそが分散です。
分散の数値がゼロに近ければデータは平均値周辺に密集しており、数値が大きければデータの散らばりが激しいことを意味します。データドリブンな意思決定が求められる現在、平均値の罠に惑わされないための必須指標となっています。
【図解と公式】分散の計算方法と求め方|偏差平方和の計算から紐解くステップ
分散の計算プロセスは、直感的に理解すると非常にシンプルです。「平均との差(偏差)をそのまま合計するとプラスとマイナスが相殺されてゼロになってしまうため、二乗してから平均を取る」という論理で成り立っています。
分散($s^2$ または $\sigma^2$)を算出する公式は以下の通りです。
$$\sigma^2 = \frac{1}{n} \sum_{i=1}^{n} (x_i - \bar{x})^2$$
※ $n$ はデータ数、$x_i$ は各データ、$\bar{x}$ はデータの平均値。
具体的なステップは次の3段階に分かれます。
- ステップ1(偏差の算出):各データの値から全体の平均値を引く($x_i - \bar{x}$)。
- ステップ2(偏差平方和の計算):求めた各偏差をそれぞれ2乗し、すべて足し合わせる($\sum (x_i - \bar{x})^2$)。
- ステップ3(平均化):偏差平方和をデータの総数(または自由度)で割る。
先ほどのAチーム(残業時間:18, 19, 20, 21, 22)で実際に計算してみます。平均値は20です。
- $(18 - 20)^2 = (-2)^2 = 4$
- $(19 - 20)^2 = (-1)^2 = 1$
- $(20 - 20)^2 = 0^2 = 0$
- $(21 - 20)^2 = 1^2 = 1$
- $(22 - 20)^2 = 2^2 = 4$
偏差平方和は $4 + 1 + 0 + 1 + 4 = 10$ となり、これをデータ数5で割ると、Aチームの分散は「2」と求まります。同様にBチームを計算すると偏差平方和は1,150となり、分散は「230」に跳ね上がります。数値の差によって、データの安定性が一目瞭然です。
【決定的な差】標準偏差との違いは何か?単位の有無と実務での使い分け
分散を学ぶ上で必ず直面する疑問が、「なぜ分散だけでなく標準偏差(Standard Deviation)を使うのか?」という点です。両者の決定的な違いは「測定単位が元のデータと一致しているかどうか」にあります。
分散は偏差を2乗して計算するため、単位も2乗されてしまいます。例えば、残業時間(時間)の分散を求めると、単位は「時間²(平方時間)」という日常では解釈不能な単位になってしまいます。金額(円)のデータであれば「円²」になってしまい、直感的な規模感が掴めません。
そこで、分散の正の平方根(ルート)を取り、単位を元の次元に戻した指標が標準偏差です。
$$\text{標準偏差} (\sigma) = \sqrt{\text{分散} (\sigma^2)}$$
実務における主要な統計指標の違いを下表に整理しました。
| 項目 | 詳細・計算定義 | 一般的な特徴・単位 | 編集部の見解・実務での活用法 |
|---|---|---|---|
| 分散(Variance) | 平均からの偏差を2乗した合計の平均値 | 単位が2乗される(例:点数²、円²) | 数式処理や理論統計、機械学習のアルゴリズム内で基盤として活用。 |
| 標準偏差(SD) | 分散の正の平方根($\sqrt{\text{分散}}$) | 元のデータと同一単位(例:点、円) | ビジネス報告書や品質管理、学校の「偏差値」算出に必須。 |
| 平均偏差(参考) | 平均からの偏差の絶対値を取った平均 | 元のデータと同一単位 | 絶対値記号を含むため数学的な微分・展開が難しく、実務では標準偏差が主流。 |
| 変動係数(CV) | 標準偏差を平均値で割った値($\sigma / \bar{x}$) | 単位のない比率(%) | 単位や平均値が大きく異なるデータ同士(例:日米の株価変動)の比較に最適。 |
理論的な数式展開やAIモデルの損失関数などでは「分散」が重宝され、人間がレポートを読んでリスクやばらつきを直感的に把握する場面では「標準偏差」が使われる、という役割分担が確立されています。
【落とし穴を回避】標本分散と不偏分散の違い|nとn-1で割る理由を徹底解剖
統計学の初学者が最もつまずきやすい難所が、「標本分散」と「不偏分散」の区別です。教科書やソフトによって、偏差平方和を「$n$」で割る場合と「$n-1$」で割る場合が存在します。
この違いは、分析対象が「全数調査」か「標本抽出(サンプリング調査)」かによって生じます。
- 標本分散($n$で割る):手元にあるデータそのもののばらつきを純粋に計算したい場合(母集団そのものを対象とする母分散も同様の考え方)。
- 不偏分散($n-1$で割る):一部のサンプル(標本)から、未知である「母集団全体の真のばらつき」を偏りなく推定したい場合。
手元の標本から計算した平均値(標本平均)は、母集団の真の平均値(母平均)に比べて、どうしても手元のサンプルデータ寄りに位置してしまいます。その結果、標本平均を使って計算した偏差平方和は、真の母分散に比べて過小評価(小さめに出る傾向)される数学的性質があります。
この過小評価のバイアスを補正し、母分散の期待値と一致させるために、分母を $n$ よりも少し小さい $n-1$(自由度)で割るのが不偏分散です。数千万人から抽出した数百人のアンケート調査など、一般的な市場調査では基本的に不偏分散が用いられます。
【現場の実態】エクセルVAR関数の使い分けと実務データ分析の現場検証
実務現場では、手計算ではなくExcelやGoogleスプレッドシートを使って分散を求めるのが一般的です。しかし、社内データ分析の現場を取材すると、「関数の選択ミス」による誤算が頻繁に起きています。
Excelには複数の分散関数が存在します。目的とデータの性質に応じた適切な関数を選択しなければなりません。
VAR.S(または旧関数VAR):不偏分散を求める(分母が $n-1$)。顧客アンケート、一部の売上サンプリングなど、母集団を推定するビジネス実務の9割以上はこれを選択。VAR.P(または旧関数VARP):標本分散・母分散を求める(分母が $n$)。全社員の健康診断結果、自社工場で生産した全ロットの検査データなど、データが母集団そのものである場合に使用。VARA/VARPA:文字列や論理値(TRUE/FALSE)を0や1としてカウントに含めて分散を計算する特殊関数。
「とりあえず検索で上に出てきたVAR.Pを使っていた」という現場の声もありますが、サンプリングデータに対してVAR.Pを使うと、ばらつきを実際よりも小さく見積もってしまい、リスク管理の甘さにつながる恐れがあります。社内テンプレートの計算式がどちらになっているか、一度点検することをおすすめします。
【応用と真価】期待値と分散の関係性から知る分散投資のメリットと盲点
分散の概念は、ファイナンスや資産運用の現場において「リスクの数値化」として中核的な役割を果たします。投資の世界における期待値と分散は、まさに「リターンとリスク」そのものです。
金融工学(現代ポートフォリオ理論)では、価格変動の大きさ(ボラティリティ)を分散(標準偏差)で定義します。期待リターンが同じ資産であっても、分散が小さい資産ほど安定した運用が可能になります。
ここで大きな武器となるのが「分散投資のメリット」です。値動きの相関が低い(あるいは逆相関の)複数の資産を組み合わせることで、ポートフォリオ全体の期待リターンを維持したまま、全体の分散(リスク)だけを引き下げることが数学的に証明されています。
【プロの結論】分散思考を使いこなせる人・誤解したまま失敗する人の特徴
統計的な分散思考を実生活やビジネスに活かせている人と、そうでない人には明確な境界線が存在します。
- 分散思考を味方にできる人:
- 「平均年収」や「平均成約率」を聞いた際、即座に「最大値・最小値や標準偏差はどれくらいか」を確認する人。
- 投資において、特定の一銘柄に集中させず、値動きの異なるアセットクラス(国内外株式・債券・不動産など)に資産を分散配分できる人。
- 業務の作業時間について、平均時間だけでなく「ばらつき(リスク幅)」を見込んで無理のない納期バッファを設計できるマネージャー。
- 分散の罠に陥りやすい人:
- 平均値だけを見て「全員がこれくらい達成できるはずだ」と現場に無理なノルマを課してしまうリーダー。
- 同じ業界のハイテク株ばかりを5銘柄買い、「複数銘柄買ったから分散投資できている」と勘違いしている投資初心者(同一セクターのため共倒れリスクが高い)。
- 分散の値をそのまま元のデータの単位と混同し、報告資料で誤った単位記載をしてしまう担当者。
【分散とは】に関するよくある質問(FAQ)
Q1:分散がマイナスの値になることはありますか?
A1:理論上、分散がマイナスになることは絶対にありません。各データと平均値の差を「2乗」した正の実数を足し合わせて計算するため、分散は必ず「0以上の数値」になります。全てのデータが全く同じ値(ばらつきゼロ)のときに限り、分散は「0」になります。計算結果がマイナスになった場合は、計算手順に誤りがあります。
Q2:平均値と中央値のどちらを基準にばらつきを見るべきですか?
A2:通常の分散や標準偏差は「平均値」を基準に計算されます。ただし、データの中に極端な外れ値(億万長者の年収など)が含まれる場合、平均値自体が引っ張られて歪んでしまいます。そうした歪んだデータでは、中央値と「四分位範囲(IQR)」を用いて散らばり具合を把握する方が実態を正確に表すケースがあります。
Q3:分散と偏差値にはどのような関係がありますか?
A3:学校のテストなどで使われる「偏差値」は、分散の平方根である標準偏差を用いて算出されます。「(個人の得点 - 平均点)÷ 標準偏差 × 10 + 50」という変換式を用いることで、平均点が異なるテスト同士でも、母集団の中で自分がどの位置(ばらつきの中の立ち位置)にいるかを一律に比較できるように規格化しています。
まとめ:データのばらつきを制する者が分析と投資の意思決定を制する
分散は、単なる教科書上の数式にとどまらず、データに潜む「不確実性」や「リスク」を可視化するための強力な武器です。平均値という一面的な数字の裏側に隠されたデータの広がりを見通すことで、ビジネスの品質管理、業務プロセスの改善、精度の高い市場予測が可能になります。
実務では、分析の目的に応じて「分散」と「標準偏差」を適切に使い分け、エクセル関数ではサンプリングデータに対してVAR.Sを正しく指定することが第一歩です。散らばりを定量化する感覚を養い、感覚や平均値の罠に惑わされない客観的な意思決定に役立ててください。 (出典: 分散 と は(Yahoo!ニュース))


Webメディアの編集およびコンテンツ作成に従事。正確で質の高い情報発信を心掛けています。