カイ二乗分布表の見方を徹底攻略!自由度と有意水準で迷わない実践術
統計検定の対策やアンケート分析の実務で必ず登場する「カイ二乗分布表」。数字がずらりと並ぶ一覧表を前にして、「縦軸と横軸のどこを見ればいいのか」「手元の数値とどう照合すればよいのか」と戸惑う方は少なくありません。データ分析の現場や大学のレポート作成において、検定の合否を左右する重要なステップでありながら、読み方を正しく体系的に教わる機会は意外と限られています。
結論から言えば、カイ二乗分布表の読み解きは「自由度(df)」と「有意水準(上側確率α)」の2点を特定するだけで完結します。この記事では、カイ二乗分布表の基本的な見方から、適合度検定や独立性の検定における自由度の求め方、さらには実務を劇的に効率化するExcel関数の活用法まで、つまずきやすい盲点を余すところなく整理してお届けします。
📌 【この記事の重要ポイントまとめ】
- 要点1:カイ二乗分布表は「自由度(縦軸)」と「有意水準(横軸)」が交差する「臨界値」を特定するだけで誰でも瞬時に読み解ける。
- 要点2:計算したカイ二乗値が臨界値より大きければ帰無仮説を棄却(有意差あり)、小さければ採択(差があるとは言えない)と判定する。
- 要点3:実務やレポートでは「CHISQ.DIST.RT」や「CHISQ.INV.RT」などのExcel関数を併用することで、表を開かずにP値と臨界値を一発算出できる。
【基本と実践】カイ二乗分布表の見方は「自由度」と「有意水準」の交点を見るだけ
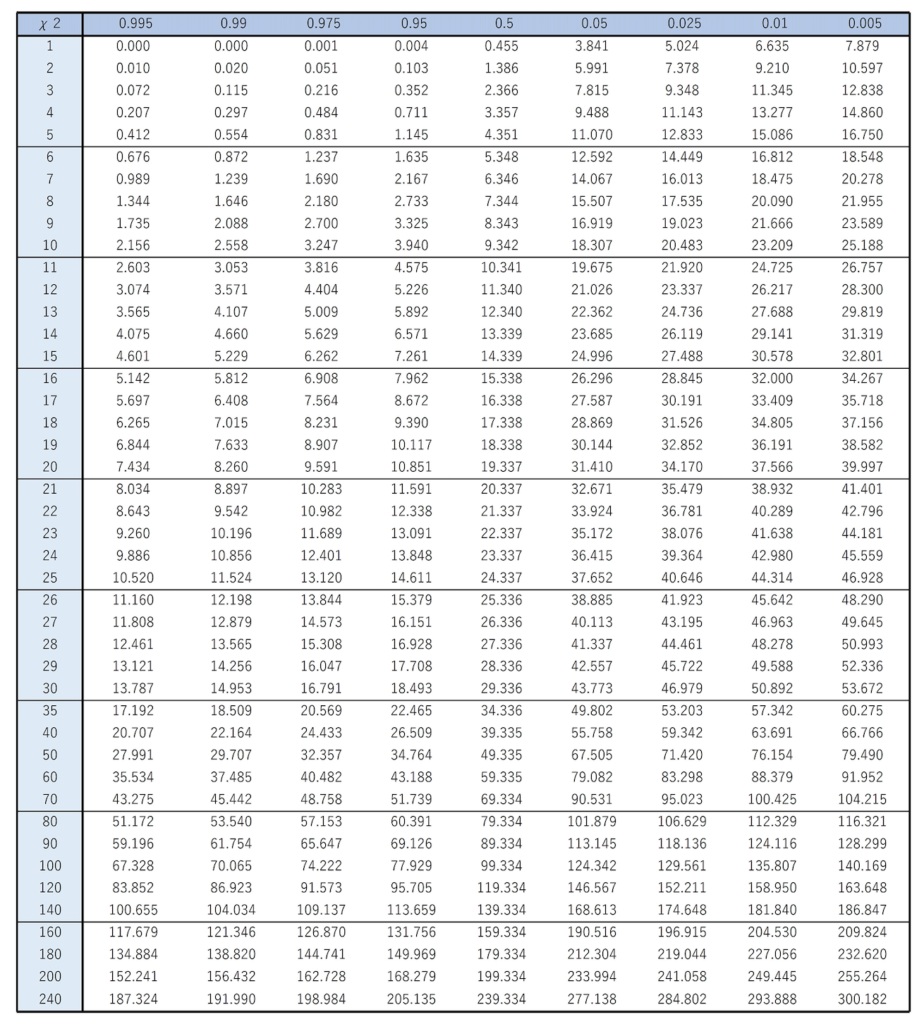
カイ二乗分布表は、検定によって得られた「カイ二乗値」が統計的に珍しい現象(偶然では説明がつかない差)なのかどうかを判定するための基準値表です。この基準となる値を臨界値(クリティカルバリュー)と呼びます。表から臨界値を読み取る手順は、以下のシンプルな3ステップに集約されます。
まず第1ステップとして、対象データの「自由度(degrees of freedom, df)」を算出します。自由度はデータのカテゴリー数やクロス集計表のサイズによって決定される値で、分布表の「縦軸(行)」に対応します。
第2ステップは、検定の厳しさを決める「有意水準(α)」の設定です。一般的な学術論文やビジネスリサーチでは5%(0.05)が標準として採用され、より厳密な判定が求められる医療分野や品質管理では1%(0.01)が用いられます。多くのカイ二乗分布表では、この有意水準が「上側確率」として「横軸(列)」に記載されています。
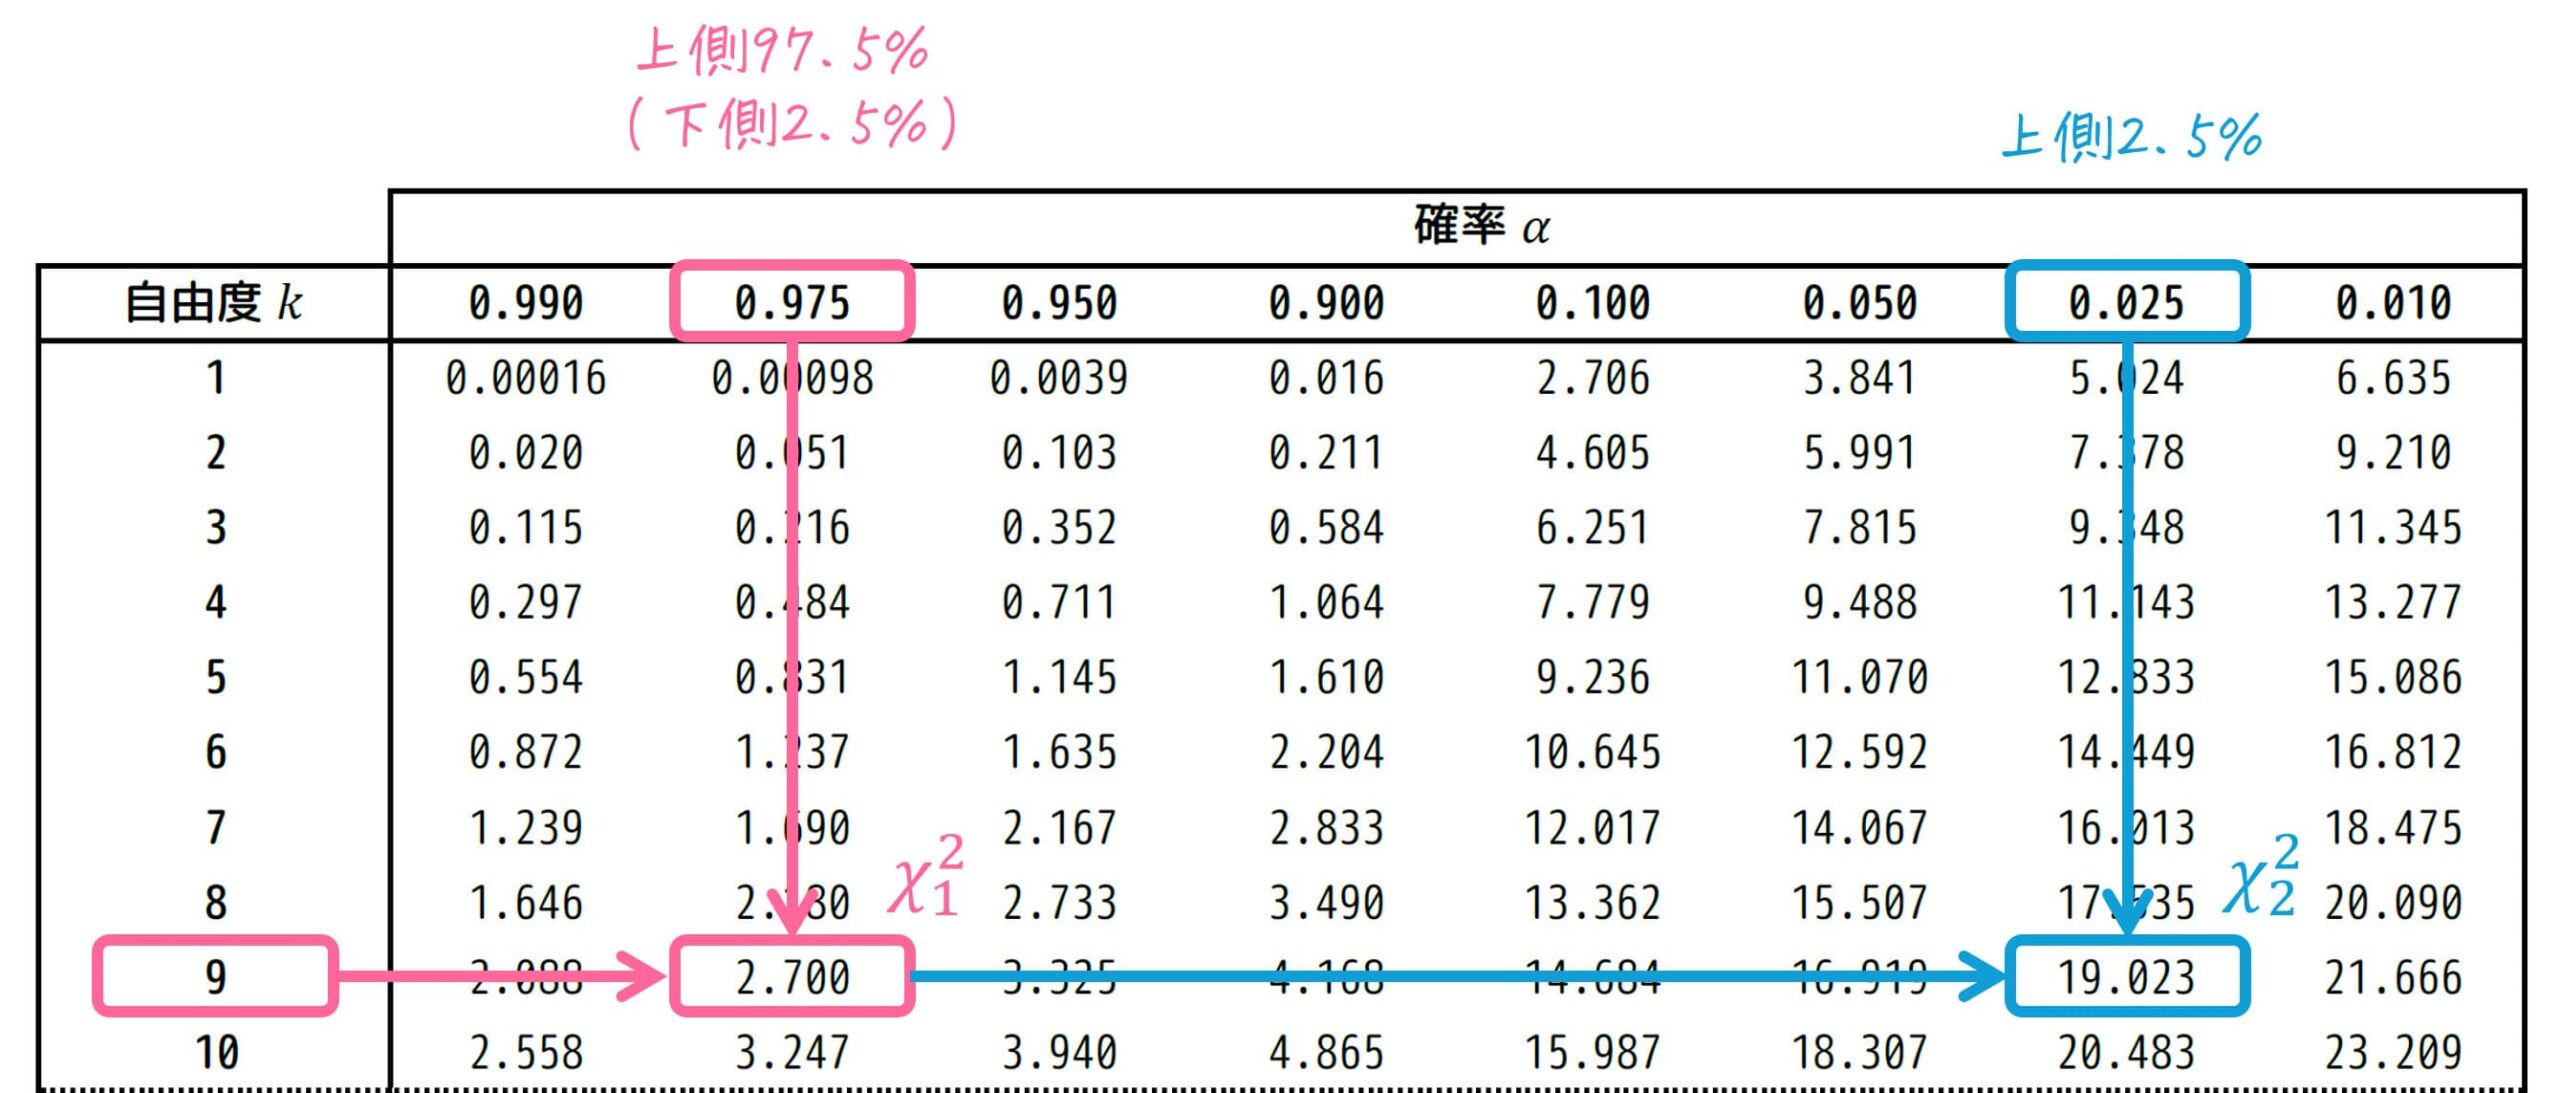
最後の第3ステップで、縦軸の自由度と横軸の有意水準が交わるセルを確認します。そこに書かれている数値こそが臨界値です。手元で計算したカイ二乗値がこの臨界値以上であれば、統計用語でいう「棄却域」に入ったことになり、「偶然とは考えにくく、有意な差(関連性)がある」と結論づけられます。
【一覧データ】カイ二乗分布の主要な臨界値早見表と判定基準
実際の分析で頻出する自由度(1〜10)と有意水準(5%・1%)における臨界値を一覧にまとめました。手元のカイ二乗値と照らし合わせる際の基準としてご活用ください。
| 自由度(df) | 有意水準 5%(α=0.05)の臨界値 | 有意水準 1%(α=0.01)の臨界値 | 編集部の見解・実務での活用ポイント |
|---|---|---|---|
| 1 | 3.841 | 6.635 | 2×2分割表(A/Bテストなど)で最も多用される基準。カイ二乗値が3.84を超えれば5%水準で有意。 |
| 2 | 5.991 | 9.210 | 3つの選択肢を持つアンケートの適合度検定や、2×3分割表で適用される数値。 |
| 3 | 7.815 | 11.345 | 4区分の比率検定(メンデルの法則など)や、2×4分割表の独立性検証に使用。 |
| 4 | 9.488 | 13.277 | 5段階評価(リッカート尺度)の適合度検定などで基準となる値。 |
| 5 | 11.070 | 15.086 | 6面サイコロの出目の偏りを検証する場合など、6カテゴリの検証で必須。 |
| 6 | 12.592 | 16.812 | 曜日別(月〜日)の来店客数データなど、7区分間の均等性を調べる際に参照。 |
| 8 | 15.507 | 20.090 | 3×5のクロス集計表など、複数属性が絡むマーケティング調査で頻出。 |
| 10 | 18.307 | 23.209 | 自由度が10を超えるとカイ二乗分布の非対称性が徐々に和らぎ、正規分布に近づく。 |
たとえば、Webサイトの改善を検証するA/Bテスト(2×2分割表、自由度1)を実施し、計算されたカイ二乗値が4.52だったとします。有意水準5%の臨界値は3.841ですから、4.52は臨界値を上回り、棄却域に入ります。この結果から「バリエーションAとBのコンバージョン率には有意な差がある」と判断できます。
【実態検証】統計検定やデータ分析現場で初心者がハマる「3大落とし穴」
SNSや知恵袋、社内データ分析の現場を見渡すと、カイ二乗分布表を扱う際に多くの方が同じ箇所でミスを犯しています。特に報告件数が多い3つの落とし穴について、実態を検証します。
1. 適合度検定と独立性の検定で「自由度の計算」を取り違える
カイ二乗検定には大きく分けて2種類あります。1つは観測データが理論上の比率に合致しているかを調べる「適合度検定」、もう1つは2つの属性間に関連があるかを調べる「独立性の検定」です。この2つでは自由度の計算式が根本から異なります。
適合度検定の自由度は「カテゴリー数 - 1」(例:サイコロの目は6区分なので 6 - 1 = 5)。対して、独立性の検定の自由度は「(行数 - 1)×(列数 - 1)」です。2×3のクロス集計表であれば (2-1) × (3-1) = 2 となります。全マス数(6マス)から1を引いて「自由度5」と誤認してしまうケースが後を絶ちません。
2. 「上側確率」と「下側確率」の定義を混同する
統計の教科書や配布される数表によって、掲載されている確率が「上側確率(右側裾の面積)」なのか「下側確率(左側からの累積面積)」なのかが異なる場合があります。カイ二乗検定の棄却域判定で必要となるのは基本的に「上側確率」です。横軸に「0.95」と書かれている表を使ってしまい、全く見当違いの数値を参照してしまうミスには十分注意してください。
3. 期待度数が小さすぎるのにカイ二乗検定を強行する
カイ二乗検定を有効に機能させるには、クロス集計表の各セルにおける期待度数が5以上であることが推奨されます(コクランの基準)。サンプルサイズが小さく、期待度数が1未満のセルが存在する場合や、5未満のセルが全体の20%を超える場合は、カイ二乗検定ではなく「フィッシャーの正確確率検定」を選択するのが統計学的な鉄則です。
【Excel実践術】カイ二乗値とP値を一瞬で算出するCHISQ関数の使い分け
2026年現在の実務環境において、紙のカイ二乗分布表を目視確認する機会は資格試験などを除いて減少しつつあります。Microsoft Excelに実装されている統計関数を活用すれば、数値を打ち込むだけで正確なP値や臨界値を瞬時に導き出せます。
実務で必須となる主要なExcel関数は以下の3つです。
① =CHISQ.TEST(実測値範囲, 期待値範囲)
クロス集計表の実測データと理論上の期待値データを指定するだけで、検定のP値(有意確率)を直接返します。算出したP値が0.05(5%)を下回っていれば、その時点で「有意差あり」と判断可能です。カイ二乗値の計算や分布表の参照を完全に省略できるため、最も実務向きの関数です。
② =CHISQ.DIST.RT(カイ二乗値, 自由度)
手動で計算したカイ二乗値と自由度を入力すると、その値より右側の面積(上側確率=P値)を返します。「CHISQ.DIST」に「.RT(Right Tail)」が付いた関数であり、カイ二乗検定の判定にはこちらを使用します。
③ =CHISQ.INV.RT(確率, 自由度)
「有意水準(例: 0.05)」と「自由度」を入力することで、カイ二乗分布表に記載されている臨界値を逆算して出力します。たとえば「=CHISQ.INV.RT(0.05, 1)」と入力すれば、セルには正確に「3.841459...」と表示されます。紙の表が手元にないときの確認に最適です。
ネット上の誤解を暴く|カイ二乗検定の「棄却域」と「P値」の正しい解釈
ウェブ上の解説記事やQ&Aサイトでは、カイ二乗検定に関して「P値が0.05以下なら効果が絶大である」といった短絡的な言説が散見されます。しかし、これは統計学的に明確な誤解です。
P値が示しているのは、あくまで「帰無仮説(差や関連がないという前提)のもとで、手元のデータと同等以上の極端な結果が得られる確率」に過ぎません。差の大きさ(効果量)そのものを保証する指標ではない点に留意する必要があります。
特にビッグデータを扱う現場では、サンプルサイズ(N数)が数千〜数万規模に膨らむと、ごくわずかな意味のない差であってもカイ二乗値が巨大化し、P値が容易に0.001を下回ってしまうという構造的性質があります。有意差が出たからといって即座に実務上のインパクトがあると過信せず、クロス集計の比率差やクラメールの連関係数(効果量)を併せて評価する姿勢が極めて重要です。
【プロの結論】分布表の手引きが必要な人・Excel処理で完結できる人の条件
状況や目的によって、分布表の理解を深めるべきか、ツールの自動計算に任せるべきかは明確に分かれます。
【紙の分布表を読み解くスキルが必須な人】
・統計検定(2級・3級など)や各種データ解析試験の受験者
・大学の統計学講義で手計算による演習課題を課されている学生
・検定の数学的ロジック(棄却域の境界線がどう動くか)を直感的に掴みたい初学者
【Excelや分析ツール(Python/R)で完結させてよい人】
・マーケティング施策のA/Bテスト判定を迅速に行いたいビジネスパーソン
・大量のアンケート設問から有意なクロス項目を一括スクリーニングしたいリサーチャー
・すでに検定の概念を理解しており、作業スピードを最優先したい実務担当者
【カイ二乗分布表】に関するよくある質問(FAQ)
Q1:カイ二乗値がマイナス(負の数)になることはありますか?
A1:絶対にありません。カイ二乗値は「(観測度数 - 期待度数)の2乗 ÷ 期待度数」の総和として計算されます。差を2乗しているため、すべての項が0以上の正の値になります。もし計算結果がマイナスになった場合は、計算手順のどこかにミスがあります。
Q2:有意水準5%と1%はどのように使い分ければいいですか?
A2:一般的なマーケティング調査、ユーザーアンケート、Webサイト改善などでは「5%(0.05)」を用いるのが業界標準です。一方、新薬の臨床試験や人命に関わる工業製品の不良品判定など、「誤って差があると判定した場合の損害(第1種の過誤)」が極めて大きいケースでは「1%(0.01)」またはそれ以下の厳しい基準を設定します。
Q3:カイ二乗検定で両側検定を行うことはありますか?
A3:通常の適合度検定や独立性の検定では、理論値からの「ズレの大きさ」そのものを検証するため、すべて片側検定(上側確率のみ)として扱います。分散の母分散検定など特殊な例を除き、カイ二乗検定の臨界値を求める際は有意水準を半分(α/2)にする必要はありません。
Q4:自由度が分布表に載っていない大きな数値の場合はどうすればいいですか?
A4:自由度が30〜100を超えるような大きな値の場合、手元の紙の表に記載がないことがあります。その際はExcelの「=CHISQ.INV.RT(有意水準, 自由度)」関数で正確な値を求めるか、カイ二乗分布の正規近似(平均=df, 分散=2df)を利用して標準正規分布から判定を行います。
まとめ:今後の動向と失敗しないための判断基準
カイ二乗分布表は一見すると複雑な数値の羅列に見えますが、その構造は「自由度で行を選び、有意水準で列を選んで交点の臨界値を見る」という極めて合理的な仕組みに基づいています。
データドリブンな意思決定が当たり前となった現代において、検定の裏側にあるロジックを理解していることは、AIツールやBIツールが出力する数値を鵜呑みにせず正しく評価するための強力な武器になります。試験対策であれば手計算と数表参照のステップを身体に馴染ませ、実務であればExcel関数を巧みに使い分けることで、統計分析のスピードと信頼性を格段に高めていきましょう。 (出典: カイ 二乗 分布 表(Yahoo!ニュース))

テクノロジーやライフスタイル領域を中心に執筆活動を行っています。趣味は写真撮影と旅行です。