過学習とは?AIの精度が急落する原因と対策・回避法を徹底解説
AIモデルの開発現場において、テスト段階では「正解率98%」を誇っていたシステムが、いざ本番環境に投入された途端に誤判定を連発するトラブルが後を絶ちません。この現象の背後にある最大の要因が「過学習(Overfitting)」です。機械学習モデルが手元のデータに過度に適応しすぎた結果、未知のデータに対する柔軟性を失ってしまう現象を指します。
開発段階の数値に惑わされ、過学習を見逃したまま実用化を進めると、システムの大幅な改修やビジネス上の大きな損失につながりかねません。本稿では、機械学習における過学習のメカニズムや原因、未学習との違いを分かりやすい身近な例えを交えて解説するとともに、現場で必須となる具体的な回避・対策アプローチを体系的に整理します。
📌 【この記事の重要ポイントまとめ】
- 要点1:過学習とは「訓練データに過剰適合し、未知のデータに対する汎化性能が著しく低下した状態」を指す。
- 要点2:主な原因は「モデル構造の過度な複雑さ」「訓練データの不足・偏り」「過剰な学習回数」の3点にある。
- 要点3:正則化(L1/L2)、ドロップアウト、交差検証、データ拡張などの対策を適切に組み合わせることで確実に抑制できる。
【超基礎】過学習とは何か?初心者にわかりやすい例えで本質を理解する
機械学習における過学習(オーバーフィッティング)とは、AIが手元にある学習用のデータを細部まで覚え込みすぎた結果、初めて目にする新しいデータ(未知データ)に対して正しい予測や分類ができなくなる状態を指します。
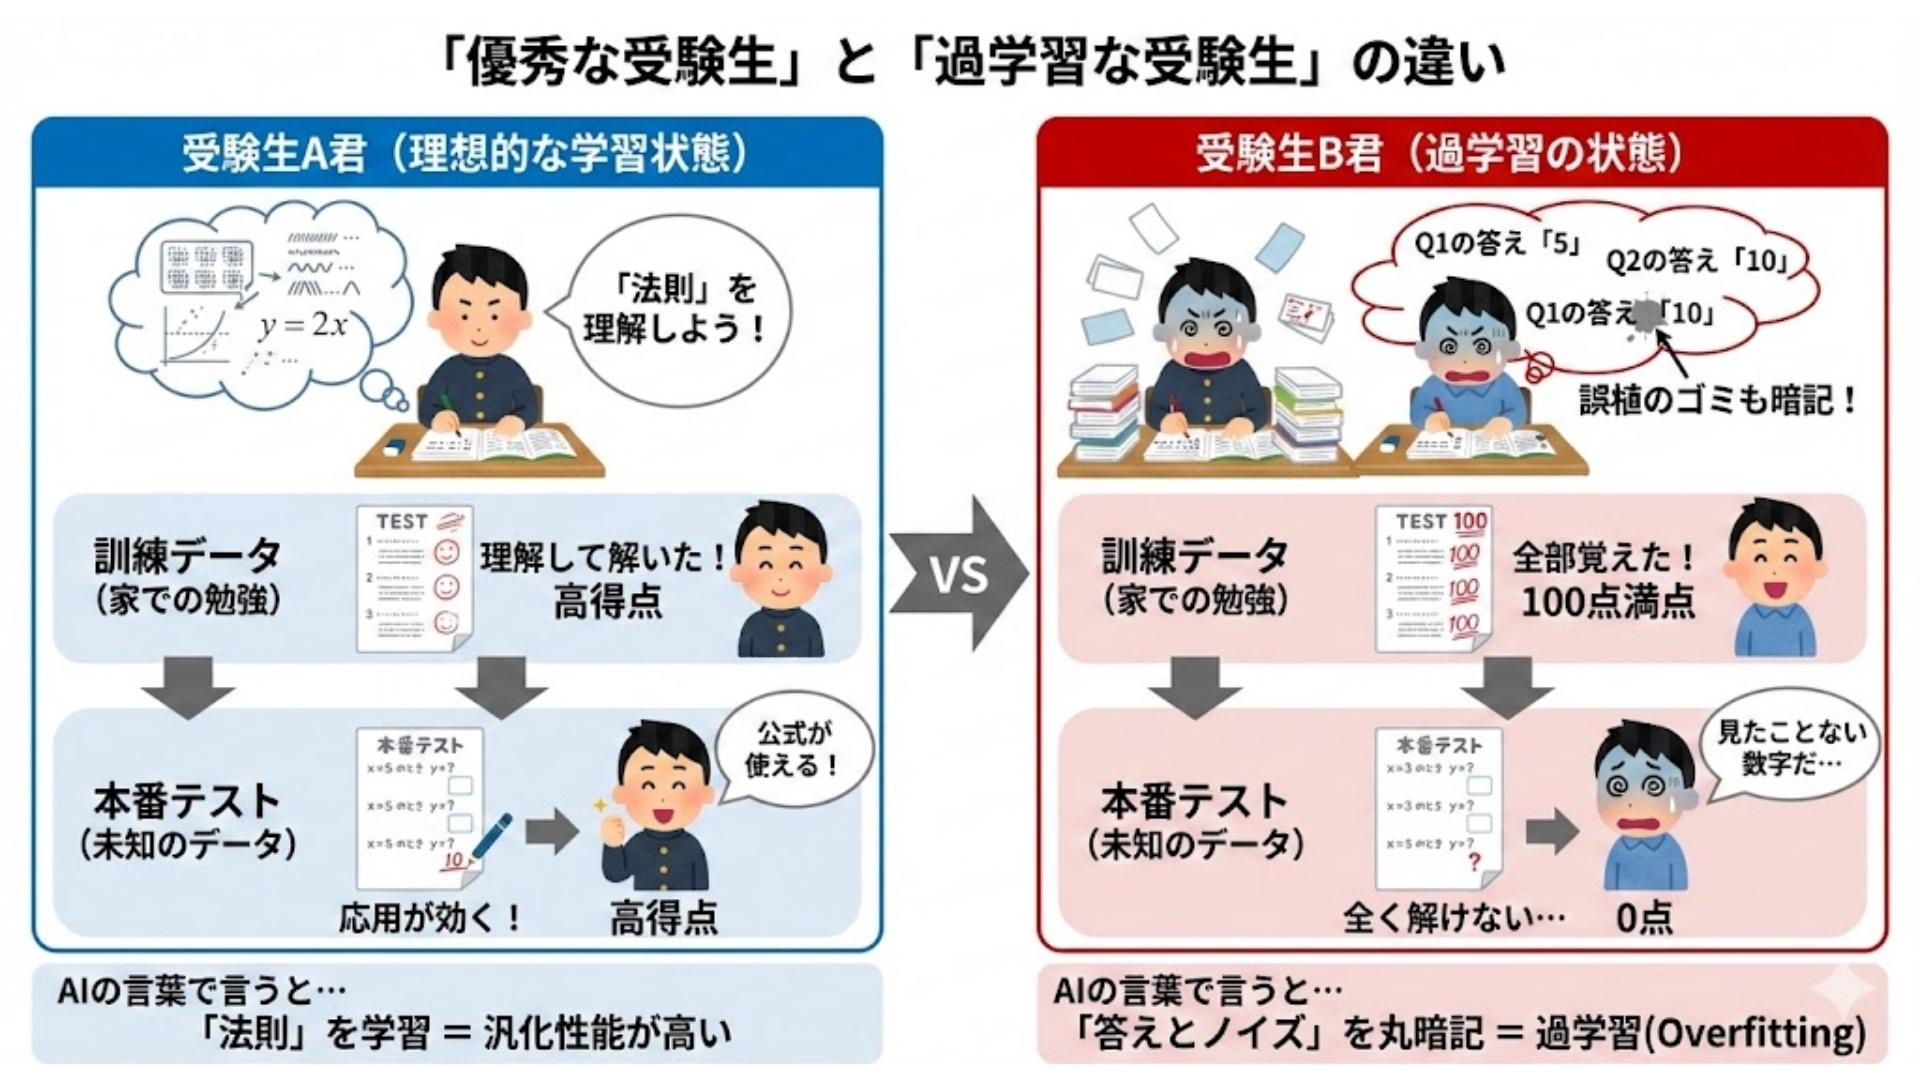
この現象を人間で例えるなら、「過去問の答えだけを丸暗記して試験本番に挑む受験生」のような状態です。過去問とまったく同じ問題が出れば100点を取れますが、問題の数値や言い回しが少し変わっただけで一気に解けなくなってしまいます。本来目指すべきは「解き方の法則やパターンを学ぶこと」であるはずが、「問題用紙のシミやフォントの癖といった本質ではない特徴」まで暗記してしまった状態が、まさにAIの過学習です。
機械学習のゴールは、訓練データだけでなく、将来入ってくるあらゆるデータに対して正しく推論できる能力、すなわち機械学習における「汎化性能(Generalization Ability)」を高めることにあります。過学習に陥ると、この汎化性能が失われ、実験室の中だけでしか機能しないモデルになってしまいます。
なぜ起こる?過学習を引き起こす3大原因と未学習との決定的な違い
過学習が発生するメカニズムは、主にデータの質・量、そしてモデルの構造という3つの要素が複雑に絡み合うことで生じます。
第1の原因は、「データの量不足とバリエーションの偏り」です。例えば、猫の画像認識AIを作る際、白い猫の写真ばかり100枚学習させると、AIは「猫=白い」と学習してしまいます。その結果、黒猫やトラ猫を見せられた際に「猫ではない」と誤判定してしまいます。ノイズや偏りを含んだ限られたデータをすべて正解として覚え込もうとすることが破綻の引き金となります。
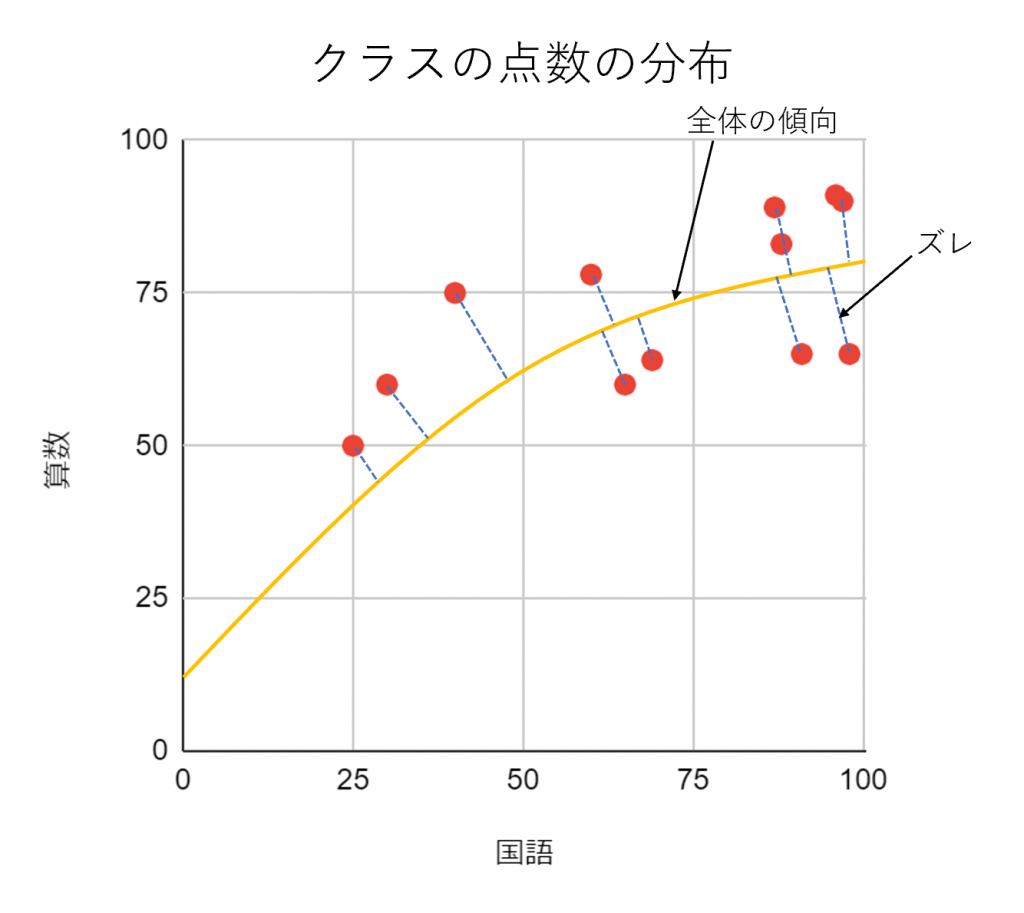
第2の原因は、「モデルの構造が複雑すぎること」です。ディープラーニングに代表される近年の高度なアルゴリズムは、数百万から数千億個ものパラメータを持っています。表現力が高すぎるあまり、データに含まれる本質的な法則だけでなく、偶然発生した無意味なノイズや外れ値まで完璧に再現する複雑な境界線を描いてしまうのです。
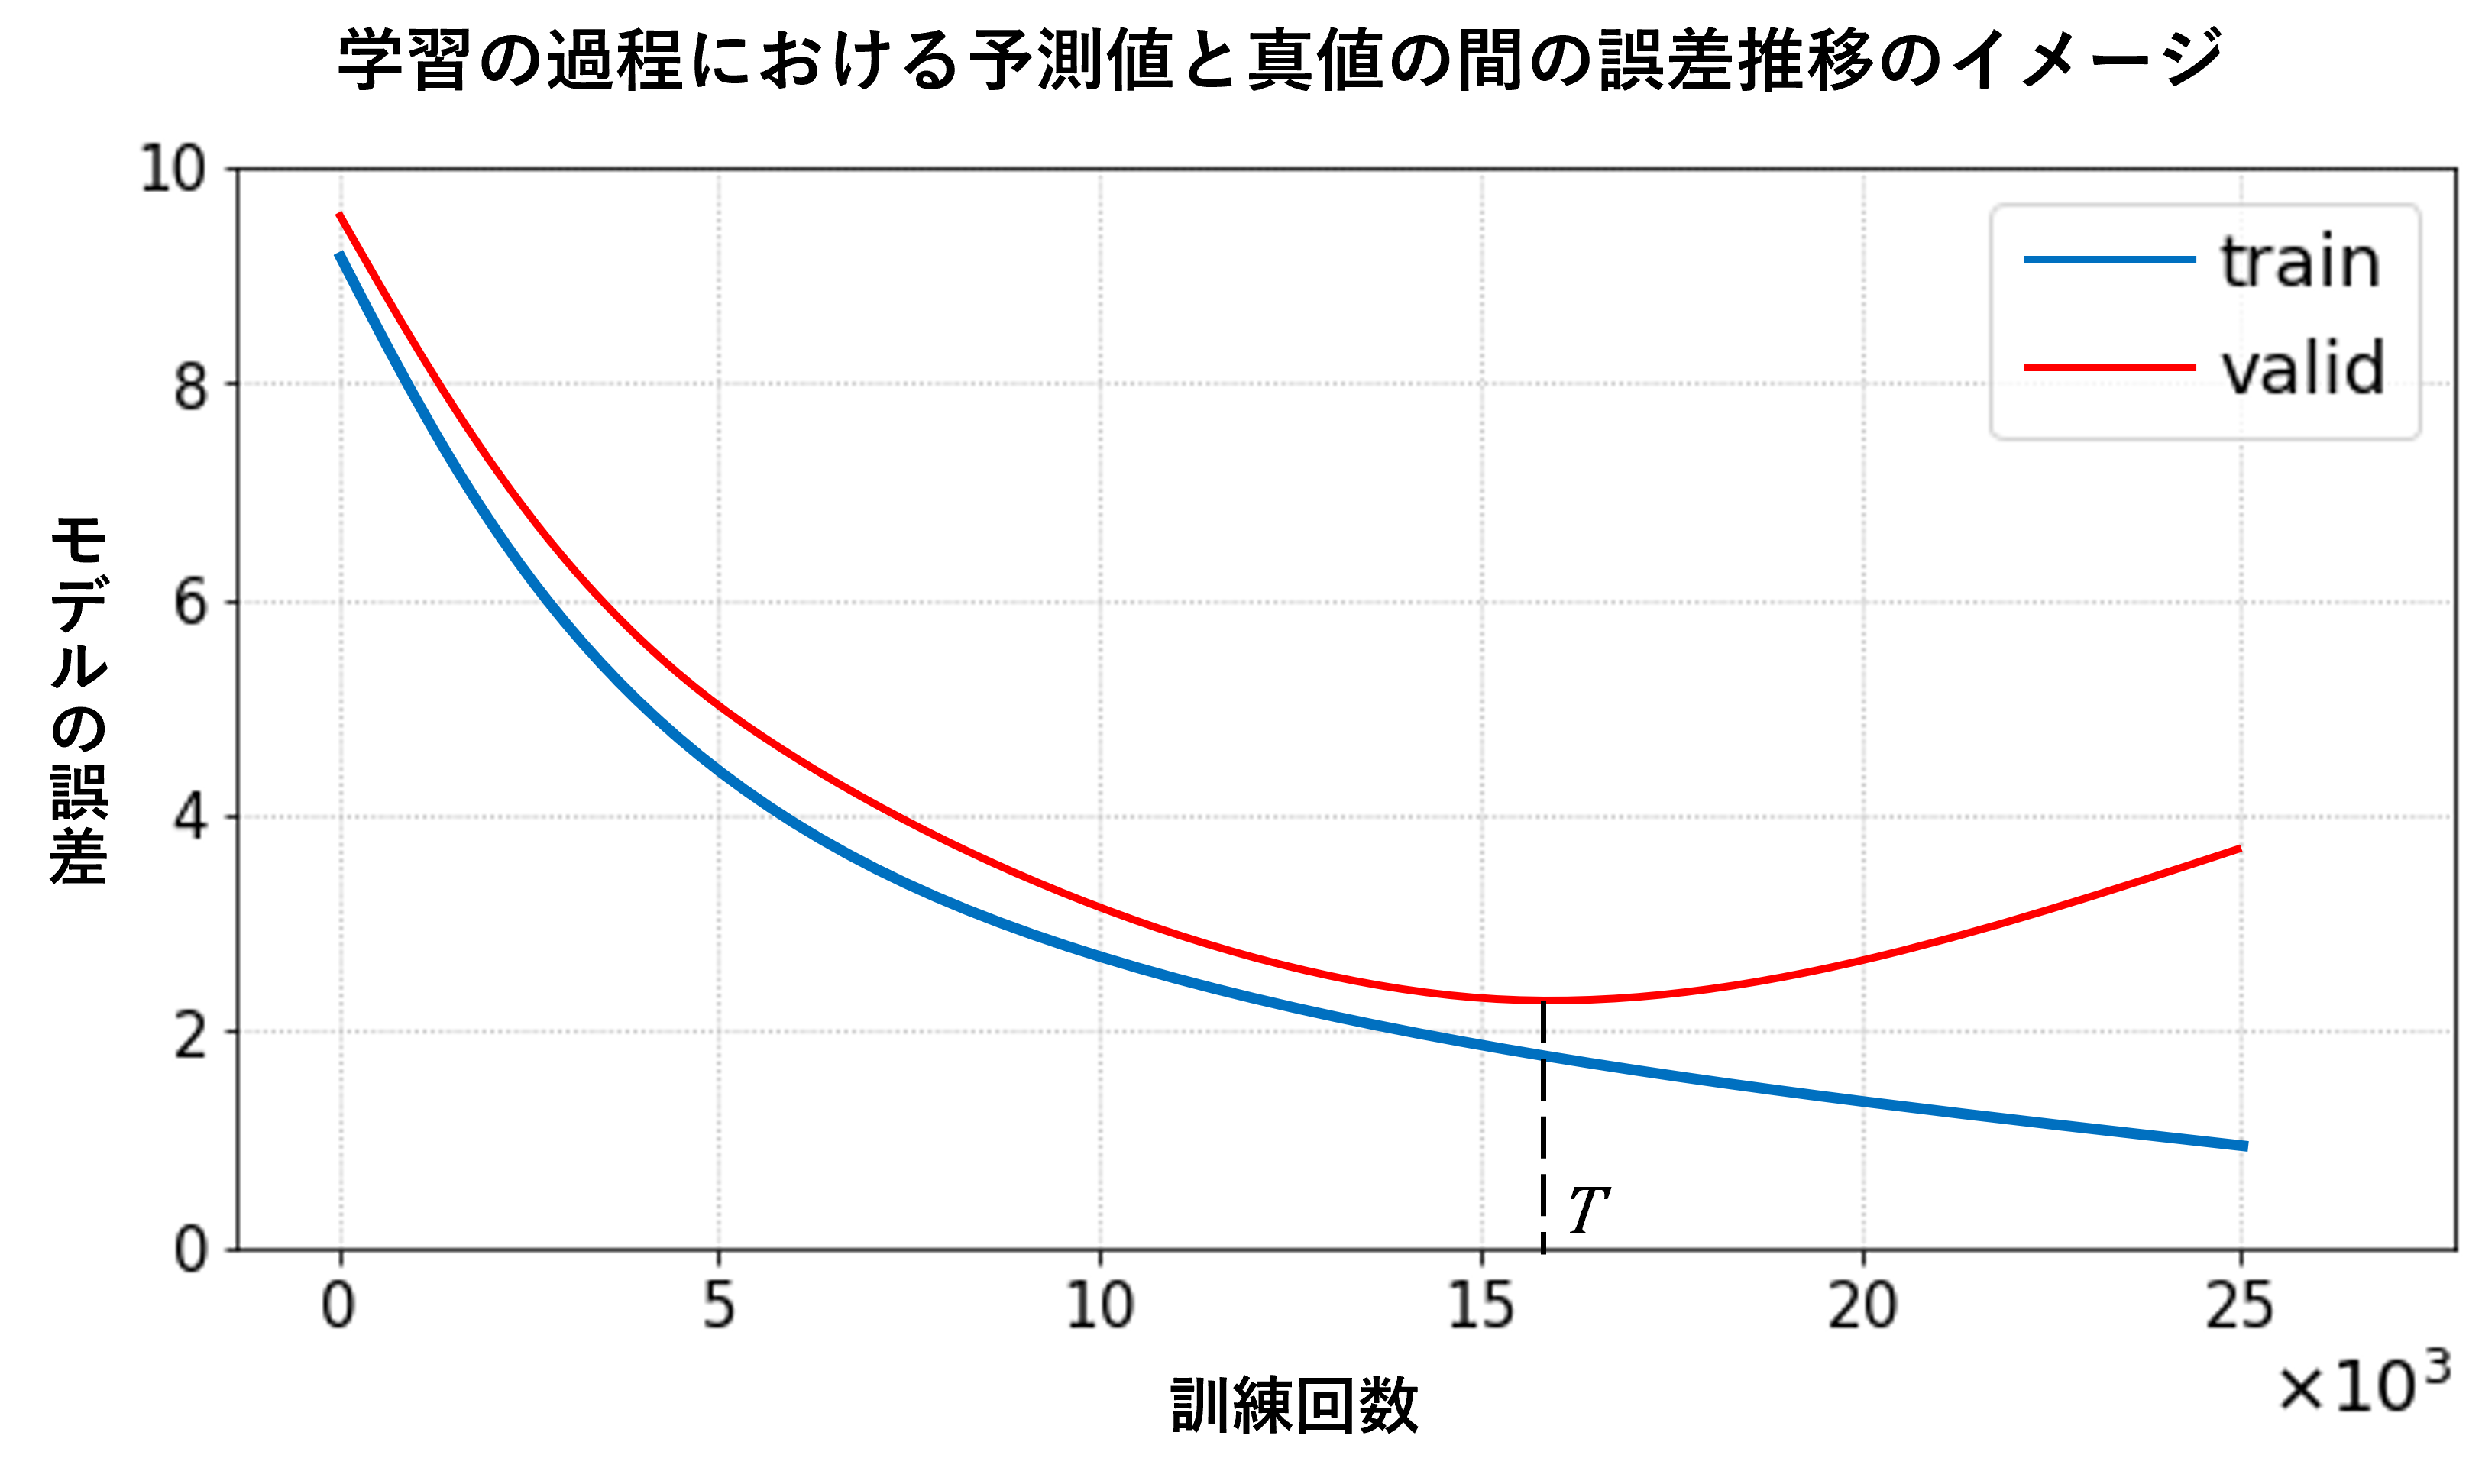
第3の原因は、「過剰な学習回数(エポック数の過多)」です。学習を繰り返せば繰り返すほど訓練データへの誤差は小さくなりますが、ある一定の閾値を超えると、未知データに対する誤差(テストロス)は逆に増加へ転じます。
過学習と未学習(アンダーフィッティング)の違い
過学習の対極に位置する概念が未学習(Underfitting)です。未学習は「勉強不足」であり、モデルがシンプルすぎるか学習が足りず、訓練データの規則性すら捉えられていない状態を指します。
| 比較項目 | 未学習(Underfitting) | 最適学習(Good Fit) | 過学習(Overfitting) |
|---|---|---|---|
| 状態の例え | 勉強不足(公式すら覚えていない) | 本質を理解(応用問題も解ける) | 丸暗記(過去問しか解けない) |
| 訓練データの精度 | 低い(例:60%) | 高い(例:92%) | 極めて高い(例:99%〜100%) |
| テストデータの精度 | 低い(例:55%) | 高い(例:90%) | 急落する(例:60%以下) |
| モデルの複雑さ | 単純すぎる(パラメータ不足) | 適切 | 複雑すぎる(パラメータ過多) |
| 主な解決アプローチ | モデルの表現力向上・特徴量追加 | 現状のハイパーパラメータを維持 | 正則化・データ拡張・モデル削減 |
【実態検証】利用者の生の声と現場目線で見えたリアル
AI受託開発や社内DXの現場では、過学習によるトラブルが後を絶ちません。実際のエンジニアコミュニティや開発現場からは、以下のような切実な摩擦や失敗談が頻繁に報告されています。
「PoC(概念実証)のレポートでは精度97%と報告し、クライアントから絶賛された。しかし翌月、本番のカメラ映像を流し込んだ瞬間に検知精度が40%台まで落ち込み、炎上プロジェクト化した」(AIベンダー エンジニア)
「異常検知モデルの開発時、正常データのバリエーションが少なすぎたため、工場の照明が少し変わっただけで『異常』とアラートが鳴り止まなくなった。完全に過学習だった」(製造業 社内データサイエンティスト)
現場で最も恐れられているのは、「開発者が過学習に気づかないままリリース判定を出してしまうこと」です。特に「データリーク(学習データの中にテストデータの情報が漏れ込む現象)」が起きていると、評価指標上は過学習が隠蔽され、本番運用開始の当日に初めて致命的な欠陥として表面化します。
過学習を確実に防ぐ7つの具体的な回避方法・対策マニュアル
過学習は適切なアプローチを講じることで確実に抑制できます。実務で標準的に用いられる過学習の回避方法を体系的に解説します。
1. データの量を増やす・データ拡張(データオーグメンテーション)
最も根本的かつ強力な過学習対策は、訓練データの絶対量を増やすことです。しかし、追加データの収集にはコストがかかります。そこで画像認識分野などで多用されるのがデータ拡張(データオーグメンテーション)です。既存の画像を反転・回転・拡大縮小・色調補正したり、一部にノイズを加えたりすることで、データの多様性を人工的に作り出します。
2. 正則化(L1正則化・L2正則化)の導入
モデルのパラメータが極端に大きな値を持たないよう、損失関数にペナルティ項(罰則)を加える手法が正則化です。
L1正則化(Lasso回帰):不要なパラメータの重みを完全に「0」にし、重要な特徴量だけを自動的に選択します。モデルのスパース化(軽量化)に適しています。
L2正則化(Ridge回帰):パラメータ全体の重みを0に近づけて滑らかに抑制します。極端な重みの偏りを防ぎ、汎化性能を高めます。
3. ドロップアウト(Dropout)の適用
ディープラーニング(深層学習)において極めて有効な対策がドロップアウトです。学習の各ステップにおいて、ニューラルネットワークのノード(ニューロン)をランダムに一定割合(例:20%〜50%)無効化して学習を進めます。特定のノード同士の過度な結びつきを断ち切り、アンサンブル学習と類似した効果を得ることで過学習を強力に防ぎます。
4. 交差検証(クロスバリデーション)による検証
データを「訓練データ」と「テストデータ」の2つに分けるだけでは、分割の偏りによって過学習を見落とす危険があります。交差検証(K-分割交差検証)では、データをK個のブロックに分割し、「K-1個で学習、残り1個で検証」というプロセスをK回繰り返して平均精度を測定します。データの偏りを排除した客観的なモデル評価が可能です。
5. アーリーストッピング(早期終了)の実装
学習の進行に伴い、訓練データの誤差は減り続けますが、検証用データの誤差はあるエポック数を境に底を打ち、上昇し始めます。アーリーストッピング(早期終了)は、検証データの誤差が悪化し始めたタイミングを自動検知し、最適な時点で学習を強制終了させる仕組みです。
6. アンサンブル学習(バギング・ブースティング)
単一の高複雑なモデルに頼るのではなく、複数のモデルを組み合わせて多数決や平均を取る手法です。ランダムフォレストに代表されるバギング手法は、バリアンス(モデルの分散・過学習度合い)を大幅に下げる効果があります。
7. 特徴量削減とモデルの簡素化
予測に寄与しない無駄な特徴量を削除し、ニューラルネットワークの層数やノード数を減らすことで、モデルの表現力をあえて抑え込み、本質的なパターンのみを捉えさせます。
一般に知られていない盲点とネットの誤解|「精度が高ければ優秀」の罠
機械学習の初心者が最も陥りやすい誤解は、「訓練データの正解率が100%に近いほど優れたAIである」という思い込みです。
実務において、訓練精度が99.9%を示しているモデルは「優秀」ではなく、ほぼ確実に「過学習を起こしている異常モデル」と判断されます。現実のビジネスデータには必ず計測ミスや環境変化といった「ノイズ」が含まれています。100%の適合を目指すことは、そうしたノイズまで真理として学習することを意味します。
統計学やAI開発には「オッカムの剃刀(同じ説明力を持つなら、より単純なモデルを選ぶべき)」という原則が存在します。わずか0.5%の訓練精度向上を求めて複雑な構造にするよりも、多少の誤差を許容するシンプルなモデルのほうが、未知の実運用環境で圧倒的に安定したパフォーマンスを発揮します。
【プロの結論】モデル選定で見極めるべき判断基準
過学習対策を設計する際は、対象となるプロジェクトのフェーズやデータ量に応じた見極めが必要です。
モデルをシンプルにすべきケース:
サンプル数が数千件未満の小規模データ、表形式データ(構造化データ)、説明責任(なぜその予測になったか)が求められる金融・医療・審査領域。
正則化・ドロップアウトを前提に高密度モデルを組むべきケース:
数十万件以上の画像・音声・テキストデータを扱うディープラーニング領域、生成AIのファインチューニング。
【過学習とは】に関するよくある質問(FAQ)
Q1:ディープラーニングでは、なぜ従来の機械学習より過学習が起きやすいのですか?
A1:モデルが保持するパラメータ数(重みやバイアス)が桁違いに多いためです。表現力が高すぎるあまり、データ内の微小なノイズまで完璧にフィッティングしてしまう性質があります。そのため、ドロップアウトや正則化、データ拡張などの過学習対策が必須となります。
Q2:正則化手法である「L1正則化」と「L2正則化」はどのように使い分ければよいですか?
A2:特徴量の数が非常に多く、不要な変数を削ってモデルを軽量化・解釈しやすくしたい場合は「L1正則化(Lasso)」を選択します。一方、変数は削らずに全体的な重みの極端な偏りを均等に抑え、予測の安定性を高めたい場合は「L2正則化(Ridge)」が適しています。
Q3:過学習が発生しているかどうかを最も簡単に確認する方法は?
A3:学習曲線(ラーニングカーブ)を可視化することです。横軸にエポック数、縦軸に損失(Loss)を取り、「訓練データの誤差」と「検証データの誤差」を同時にプロットします。訓練データの誤差が下がり続けているにもかかわらず、検証データの誤差が途中から上昇に転じていれば、その乖離が過学習の明確な証拠です。
Q4:テストデータの精度も高い場合、過学習は完全に否定できますか?
A4:注意が必要です。「データリーク」が発生している場合、テストデータ自体が訓練データと似通った情報を含んでしまい、見かけ上のテスト精度が高くなることがあります。時系列データであれば未来のデータが過去に漏れていないか、顧客単位でデータが正しく分離されているかを厳密に検証する必要があります。
まとめ:過学習を克服し実用的なAIモデルを構築するための鉄則
過学習は、機械学習・AI開発において避けては通れない普遍的な課題です。どれほど高度なアルゴリズムを用いても、適切なデータ管理とバリデーション設計が伴わなければ、現場で使える実用モデルには仕上がりません。
「訓練データとテストデータの明確な分離」「交差検証の徹底」「適切な正則化手法の導入」を標準プロセスとして組み込み、見かけの精度に惑わされない評価体制を築くことが、プロジェクト成功への最短ルートとなります。 (出典: 過 学習 と は(Yahoo!ニュース))
テクノロジーやライフスタイル領域を中心に執筆活動を行っています。趣味は写真撮影と旅行です。