標本標準偏差の計算と「なぜn-1で割るのか」を徹底解説【2026年最新】
データ分析や業務レポートを作成する際、「標準偏差」の計算で一度は立ち止まった経験があるのではないでしょうか。特に多くの人が頭を抱えるのが、「なぜ標本標準偏差ではデータの個数 $n$ ではなく $n-1$ で割るのか」という疑問です。学校の講義やExcelの関数選択でモヤモヤしたまま放置されがちなこの問題は、データから全体像を正しく見抜くための極めて重要な統計的基盤を含んでいます。
ビッグデータやAI活用が実務の標準となった2026年現在、現場で取得できるデータの大半は「母集団全体」ではなく一部を抜き出した「標本(サンプル)」です。本記事では、母標準偏差との本質的な違いから、$n-1$(自由度)で割る数学的・直感的な理由、Excel関数(STDEV.S / STDEV.P)の現場での使い分け、手計算の具体例まで、専門記者の視点でわかりやすく解き明かします。
📌 【この記事の重要ポイントまとめ】
- 要点1:標本標準偏差は「手元のデータ(標本)から未知の母集団のばらつきを推定する」ために用いる指標である。
- 要点2:計算で $n-1$ で割る理由は、標本平均を使うことで生じる「ばらつきの過小評価」を補正し、偏りのない推定(不偏性)を行うためである。
- 要点3:実務のExcelでは、全数調査なら「STDEV.P」、一部の抜き取りサンプルなら「STDEV.S」を選択するのが鉄則である。
【統計学の基礎】標本標準偏差とは?母標準偏差との決定的な違い
統計学において、標準偏差は「データのばらつき度合い(平均値からの離れ具合)」を数値化したものです。標準偏差が大きければデータが広範囲に散らばっており、小さければ平均値付近に密集していることを示します。
ここで初心者が最初につまずくのが、「母標準偏差」と「標本標準偏差」の混同です。両者の最大の違いは、手元にあるデータが「対象のすべて(母集団)」なのか、それとも「一部を抜き出したもの(標本)」なのかという点にあります。
| 比較項目 | 母標準偏差(Population SD) | 標本標準偏差 / 不偏標準偏差(Sample SD) |
|---|---|---|
| 対象データ | 母集団の全データ(全数調査) | 母集団から抽出したサンプルデータ(標本調査) |
| 主な目的 | 母集団そのものの真のばらつきを測定 | 標本から母集団の真のばらつきを母集団推定 |
| 分散の除数 | データの総数 $n$(または $N$) | 自由度 $n-1$ |
| Excel関数 | STDEV.P(旧:STDEVP) | STDEV.S(旧:STDEV) |
| 記号表記 | $\sigma$(シグマ) | $s$ または $s_x$ |
たとえば、日本国内で販売された特定の工業製品10万個すべての耐久時間を測定できるなら「母標準偏差」を用います。しかし現実的にはコストや手間の問題で、無作為に抽出した100個だけをテストするのが一般的です。この100個から「全体の10万個はどれくらいばらついているか」を逆算して推測する際に用いるのが「標本標準偏差」です。
【最大の疑問を解明】標本標準偏差の計算で「なぜn-1で割るのか」
統計学の学習者から最も多く寄せられる疑問が、「なぜデータの個数 $n$ そのままではなく、$n-1$ で割るのか」という点です。これを理解するためには、「不偏分散」と「自由度」という概念を知る必要があります。
もし、手元の標本データに対して通常の平均値と分散の公式($n$ で割る計算)をそのまま適用すると、算出される標本分散は母集団の真の分散よりも小さめに出てしまう(過小評価される)という致命的な性質があります。
直感的な理由は次のとおりです。本来の母分散は「真の母平均」からのズレを測ります。しかし、手元にある標本データで計算するときは、未知の母平均の代わりに「標本平均」を使わざるを得ません。標本平均は当然ながら「その標本データたち自身の重心」ですから、標本データは母平均よりも標本平均の近くに集まります。その結果、計算されるズレ(平方偏差)の合計は、真の母集団に対するズレよりも必ず小さくなってしまうのです。
この「縮んでしまったばらつき」を補正し、期待値を母分散に一致させるために、分母を $n$ よりも少し小さい $n-1$ にして数値を引き上げます。この $n-1$ で割って求めた分散を不偏分散と呼び、その平方根(ルート計算)をとったものを一般に標本標準偏差(不偏標準偏差)と呼びます。1つの平均値を標本から固定して使ったことで、自由に動けるデータの個数(自由度)が1つ減って $n-1$ になった、と捉えるのが統計学の標準的な解釈です。
【ステップ解説】標本標準偏差の求め方と計算式の具体例
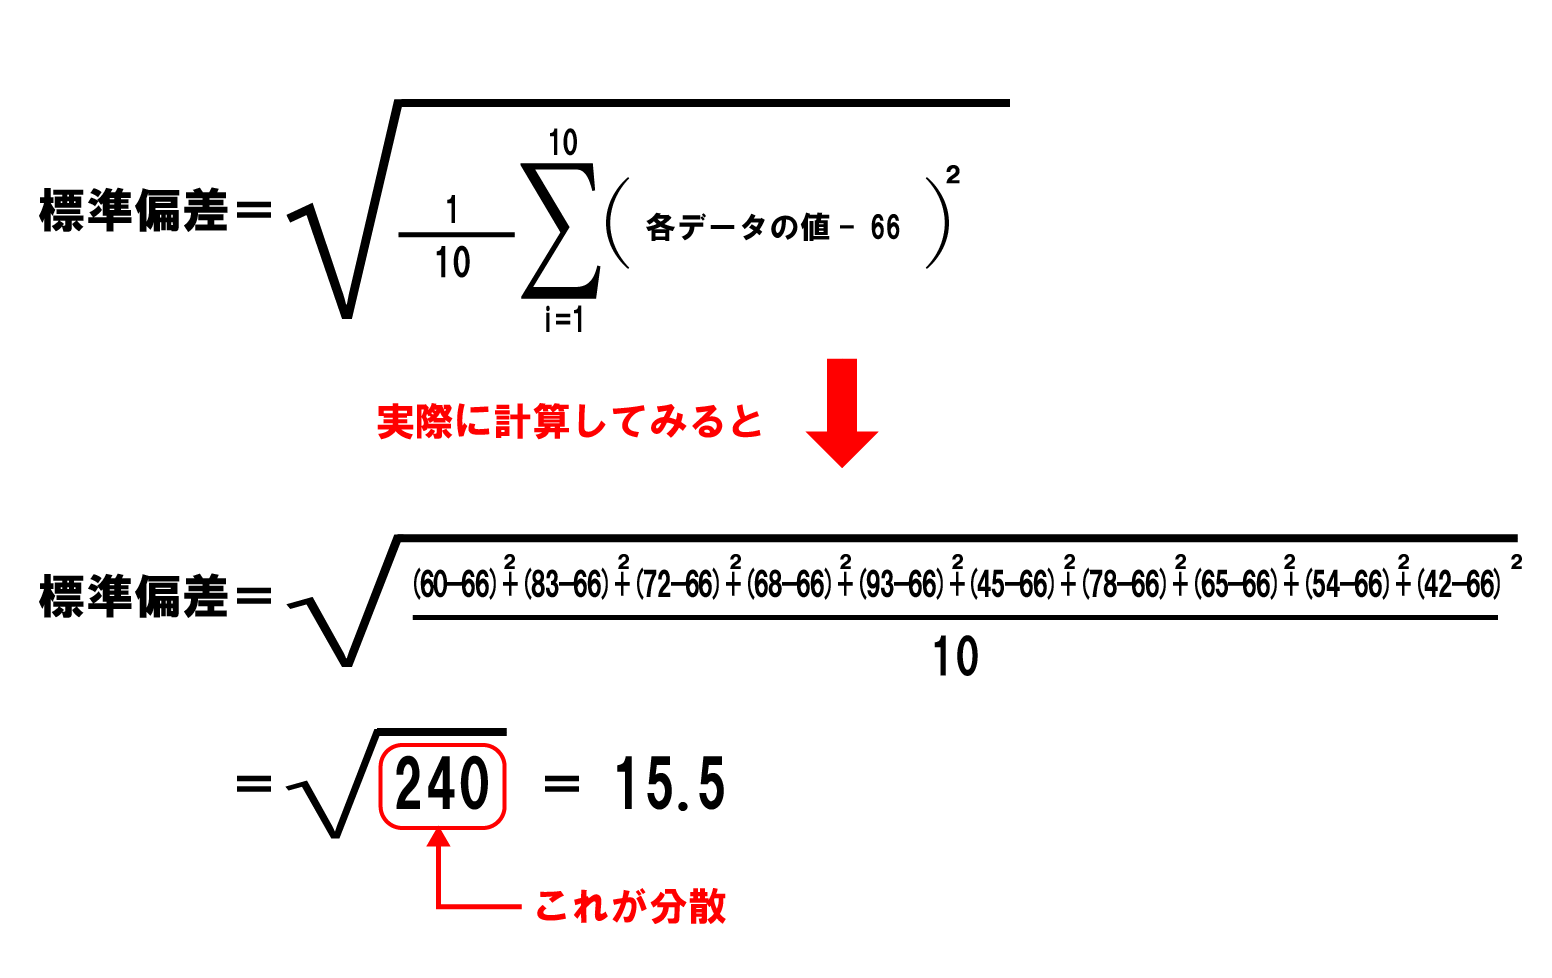
標本標準偏差の計算式は一見複雑に見えますが、順を追って計算すれば決して難しくありません。基本となる数式は以下の通りです。
$s = \sqrt{\frac{1}{n-1} \sum_{i=1}^{n} (x_i - \bar{x})^2}$
ここからは、具体例として「5人のテストの点数:[60点, 70点, 80点, 85点, 95点]」というサンプルデータを使い、ステップ順に手計算してみましょう。
ステップ1:標本平均($\bar{x}$)を求める
まず、手元にある5つの数値の合計をデータ数5で割ります。
$(60 + 70 + 80 + 85 + 95) \div 5 = 390 \div 5 = \mathbf{78}$(点)
ステップ2:各データと平均値の差(偏差)を二乗して合計する
各データから平均78を引いて二乗し、それらをすべて足し合わせます(偏差平方和)。
- $(60 - 78)^2 = (-18)^2 = 324$
- $(70 - 78)^2 = (-8)^2 = 64$
- $(80 - 78)^2 = 2^2 = 4$
- $(85 - 78)^2 = 7^2 = 49$
- $(95 - 78)^2 = 17^2 = 289$
合計:$324 + 64 + 4 + 49 + 289 = \mathbf{730}$
ステップ3:自由度(n-1)で割って不偏分散を求める
データ数 $n = 5$ なので、自由度は $5 - 1 = 4$ となります。偏差平方和を4で割ります。
$730 \div 4 = \mathbf{182.5}$(これが不偏分散です)
ステップ4:ルート計算を行って標本標準偏差を算出する
不偏分散の平方根をとります。
$\sqrt{182.5} \approx \mathbf{13.51}$(点)
このように、「平均を出す → 差の2乗を足す → $n-1$ で割る → 平方根をとる」という4つのステップで標本標準偏差が求まります。
【実務で迷わない】エクセル関数「STDEV.S」と「STDEV.P」の使い分け
ExcelやGoogleスプレッドシートで標準偏差を計算する際、関数の選択ミスは業務上の分析ミスに直結します。現在利用されている主要な関数は以下の2種類です。
STDEV.S(SampleのS):不偏標準偏差を求める関数(内部で $n-1$ で割る計算を実施)。STDEV.P(PopulationのP):母標準偏差を求める関数(内部で $n$ で割る計算を実施)。
※なお、古いバージョンの関数であるSTDEVは現在のSTDEV.Sと、STDEVPはSTDEV.Pと同じ動作をしますが、互換性維持のためのレガシー関数ですので、新規作成時は必ず末尾に「.S」や「.P」が付いた関数を使いましょう。
【プロの結論】どちらの関数を選ぶべきかの明確な判断基準
判断に迷ったときは、次の基準で選定してください。
✅ STDEV.S を選ぶべきケース:
・顧客満足度アンケートの回答結果(全顧客の一部から得た回答)
・抜き取り検査による製品の寸法データ
・WebサイトのABテストにおけるコンバージョン率の検証データ
・実務・研究における一般的なデータ分析の大半(サンプルデータ)
✅ STDEV.P を選ぶべきケース:
・全社員(100%)を対象とした健康診断の測定結果
・あるクラス全員(欠席者ゼロ)の期末テストの成績
・過去1年間に自社ECで発生した「すべてのトランザクションログ」そのものの集計
一般に知られていない盲点とネットの誤解
標本標準偏差を扱う際、ネット上の解説記事やコミュニティで頻繁に見受けられる「2大誤解」があります。誤ったデータ解釈を避けるために必ず押さえておきましょう。
誤解1:「標本標準偏差」と「標本平均の標準誤差(SE)」の混同
実務のプレゼン資料で非常によく混同されるのが、標準偏差(Standard Deviation: SD)と標準誤差(Standard Error: SE)です。
・標準偏差(SD):個々のデータのばらつきを表す指標。
・標準誤差(SE):標本平均そのものが「真の母平均からどれくらいズレ得るか」を表す指標($SE = s / \sqrt{n}$ で計算)。
「データの散らばりを見せたい」のか、「推定した平均値のブレ幅(信頼性)を示したい」のかで使う指標が全く異なります。エラーバーをつける際はどちらを描画しているのかを必ず明記してください。
誤解2:「不偏分散の平方根をとれば、標準偏差も完全に不偏になる」という勘違い
数学的に厳密な話をすると、分散を $n-1$ で割った「不偏分散」の期待値は母分散と完全に一致しますが、その平方根をとった標本標準偏差(不偏標準偏差)は、母標準偏差に対してわずかに過小推定(偏り)を持ちます。これは平方根関数が非線形(上に凸)であることに起因します。
ただし、実務や一般的な統計的推測では、このわずかな偏りは無視できるほど小さいため、不偏分散の平方根をそのまま標本標準偏差として用いるのが国際的な実務スタンダードとなっています。
【標本 標準 偏差】に関するよくある質問(FAQ)
Q1:データ数 $n$ が十分に大きい場合、$n$ で割っても $n-1$ で割っても結果は変わりませんか?
A1:その通りです。たとえばサンプル数が $n=10$ の場合、$10$ と $9$ では約5.4%の差が出ますが、$n=1,000$ の場合、$1,000$ と $999$ の比率は約0.05%の差しかありません。サンプルサイズが十分に大きければ実質的な数値の差はほぼ消滅しますが、理論的な正しさと再現性を担保するため、標本データに対しては常に $n-1$(STDEV.S)を用いるのが鉄則です。
Q2:アンケート調査の分析で、どちらの標準偏差を使うべきか迷った場合はどうすればよいですか?
A2:基本的には STDEV.S(標本標準偏差) を選択してください。アンケートは対象集団(見込み客全体や社会全体)から一部の回答を得ているケースが99%以上であるため、標本調査として扱うのが適切です。
Q3:なぜExcelには「STDEVA」や「STDEVPA」といった末尾にAがつく関数があるのですか?
A3:末尾に「A」がつく関数は、セル内に文字列や論理値(TRUE/FALSE)が含まれていた場合に、それを「0」や「1」として計算に含める仕様の関数です。通常の数値データのみを扱う場合は、誤認識を防ぐためにも「STDEV.S」または「STDEV.P」を使用してください。
まとめ:今後のデータ分析で失敗しないための実践チェック
標本標準偏差の計算において $n-1$ で割る理由は、「手元のサンプルから見えない母集団の真の姿を、偏りなく推定するための知恵」に他なりません。
日々のビジネスや研究でデータを扱う際は、まず「このデータは全体(母集団)なのか、一部(標本)なのか」を自問自答してください。一部のサンプルであれば迷わず $n-1$ の計算式、あるいはExcelの STDEV.S を選択する。この基本ルールを徹底するだけで、誤った分析レポートによる意思決定のミスを確実に防ぐことができます。 (出典: 標本 標準 偏差(Yahoo!ニュース))

Webメディアの編集およびコンテンツ作成に従事。正確で質の高い情報発信を心掛けています。