目標文字列と一致している文字数を適応度とする
無数の選択肢の中から「最も効率的なルート」や「最も強度の高い構造」を導き出さなければならないとき、従来の総当たり計算では膨大な時間がかかり、現代のスーパーコンピュータですら太刀打ちできません。そこで威力を発揮するのが、数十億年にわたる生物の進化プロセスを計算機上で再現した「遺伝的アルゴリズム(Genetic Algorithm: GA)」です。
2026年の産業界では、生成AIや深層学習と並び、物流配送ルートの自動最適化から半導体回路の配置、新素材探索に至るまで、実用的な最適化エンジンとしてGAの再評価が進んでいます。なぜ自然淘汰の真似事をするだけで、人間には思いつかない精密な最適解へと辿り着けるのか。基礎理論からPythonでの実装イメージ、現場で直面するリアルな壁まで、徹底的に解き明かします。
📌 【この記事の重要ポイントまとめ】
- 要点1:遺伝的アルゴリズムは「選択」「交叉」「突然変異」を繰り返すことで、天文学的な探索空間から実用的な準最適解を高速に導き出すメタヒューリスティクス技術である。
- 要点2:勾配計算が不要なため、関数の形状が不連続・非線形な「巡回セールスマン問題」や構造設計などの複雑な最適化問題に対して圧倒的な適応力を誇る。
- 要点3:局所解(局所最適解)に陥るリスクやパラメータ調整の難しさといったデメリットも存在し、機械学習モデルの構造探索(NAS)など複合型AIとしての活用が主流となっている。
【なぜ最適解が見つかるのか】生物の進化を模倣する驚異のメカニズム
遺伝的アルゴリズム(GA)の根底にあるのは、チャールズ・ダーウィンが提唱した「適者生存」の進化論です。問題の解決策(解の候補)を「個体」に見立て、その特徴を0と1のビット列や数値配列などの「遺伝子(染色体)」としてデータ化します。初期状態ではランダムに生成された集団からスタートしますが、世代交代を繰り返すうちに、驚くべきスピードで洗練された解へと収束していきます。
このプロセスを制御するのが、以下の4つの基本ステップです。
- 適応度評価(評価関数):各個体がどれだけ目的に適しているかを数値化する。例えば、配送ルート問題なら「総移動距離の短さ」が適応度となる。
- 選択(Selection):適応度が高い優秀な個体を次世代の親として優先的に選出する(ルーレット選択やトーナメント選択など)。
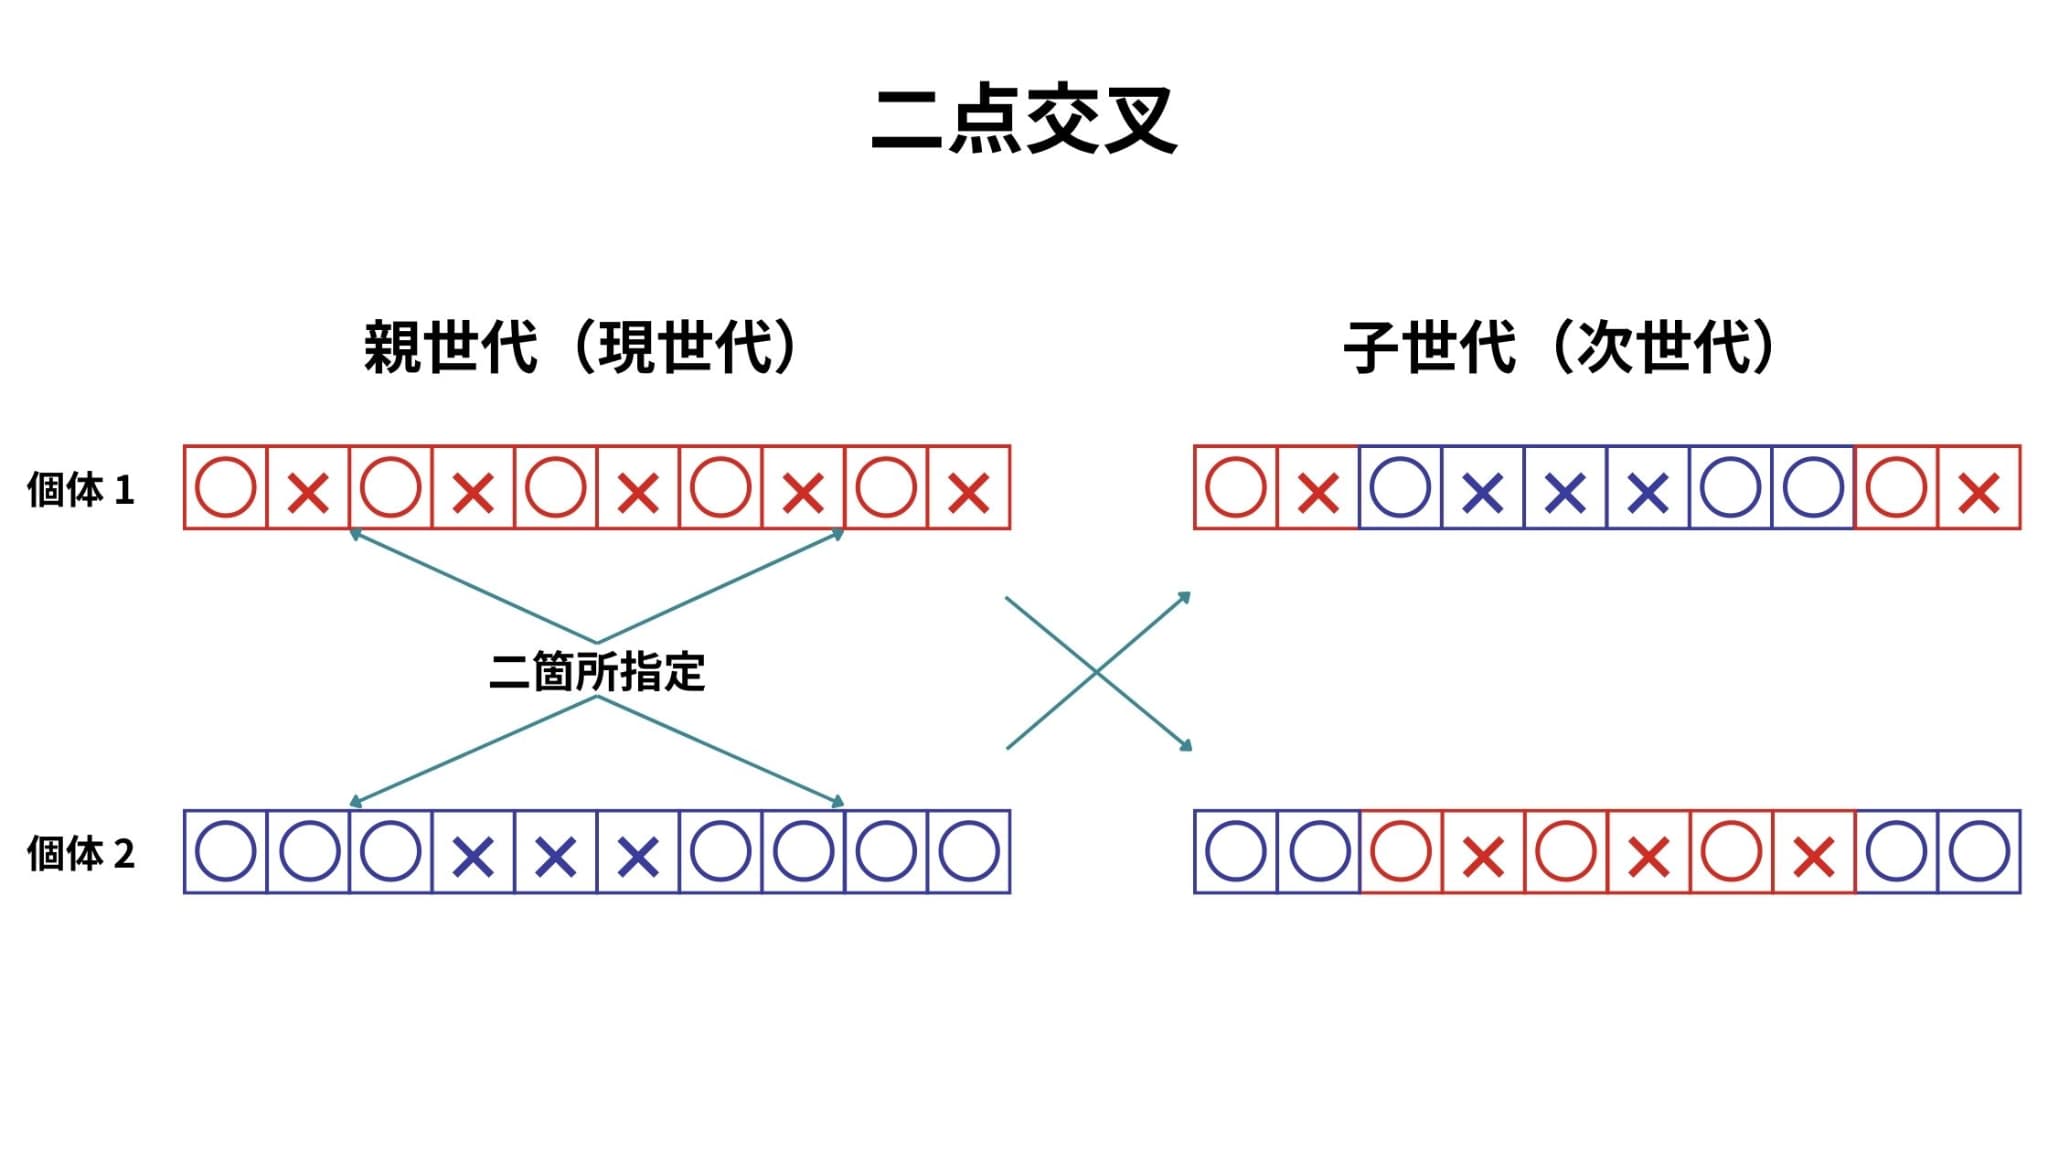
- 交叉(Crossover):選ばれた2つの親個体の遺伝子情報を掛け合わせ、新たな子個体を生成する(1点交叉、2点交叉、一様交叉など)。
- 突然変異(Mutation):一定の低い確率(通常は0.1%〜2.0%程度)で遺伝子の一部をランダムに書き換える。これにより、集団内の多様性を維持し、初期段階での思考停止を防ぐ。
数世代から数千世代にわたってこのサイクルを回すことで、人間が最初から論理的に組み上げることが不可能なほど複雑な条件下でも、極めて優れた「最適解(または実用的な近似解)」が自然発生的に立ち現れます。
【機械学習との決定的な違い】メタヒューリスティクス最適化の立ち位置
AIやアルゴリズムの文脈で混同されがちなのが、深層学習(ディープラーニング)をはじめとする「機械学習」と、遺伝的アルゴリズムが属する「メタヒューリスティクス最適化」の違いです。
機械学習は基本的に「大量のデータからパターンやルールを学習・予測する」技術です。一方で遺伝的アルゴリズムは、「与えられた制約と目標関数の中で、最適なパラメータの組み合わせを探索する」手法です。教師データを用意できない未知の環境や、数式で微分できない複雑な評価基準に対しても直接適用できる点が、GAの決定的な強みです。また、プログラムの構造そのものを木構造の遺伝子として進化させる遺伝的プログラミング(GP)へと発展させれば、数式そのものを自動生成することも可能になります。
| 項目 | 詳細・数値データ | 一般的な基準・相場 | 編集部の見解・評価 |
|---|---|---|---|
| 探索アプローチ | 生物進化模倣(集団探索型) | 単一解探索または勾配降下法 | 微分不可能なブラックボックス問題にも強い耐性を持つ |
| 教師データの要否 | 不要(評価関数のみ定義) | 数千〜数百万件のデータが必要 | 過去データが存在しない新規設計やスケジューリングに最適 |
| 計算収束速度 | 世代数:数十〜数万世代(数秒〜数時間) | エポック数:数時間〜数日 | 完全な最適解の保証はないが、実用解への到達速度は極めて高い |
| 局所解回避能力 | 突然変異率(0.5%〜3%)で調整 | 局所解トラップに陥りやすい手法も多数 | 多様性維持メカニズムにより広大な探索空間をカバー可能 |
【現場の実態検証】産業界のリアルな応用例とエンジニアの試行錯誤
理論上は美しく見える遺伝的アルゴリズムですが、実際の開発現場ではどのような成果を上げているのでしょうか。代表例として挙げられるのが、典型的なNP困難問題である「巡回セールスマン問題(TSP)」です。配送拠点が30箇所を超えると、総組み合わせ数は宇宙の原子数をも凌駕する2.65×10^32通りに達し、力ずくの計算は不可能です。しかしGAを用いれば、一般的なPC環境でもわずか数分でプロの配車係が唸るような高効率ルートを弾き出します。
国内の著名な応用実績として、JR東日本の新幹線「E5系(はやぶさ)」の先頭形状(アローライン)開発があります。騒音低減とトンネル微気圧波の抑制という相反する物理要件をクリアするため、スーパーコンピュータ上で遺伝的アルゴリズムによる多目的最適化が活用されました。
一方で、開発現場のエンジニアからは以下のようなリアルな摩擦や課題も報告されています。
- 評価関数の設計負荷:「適応度をどう定義するか」にプロジェクト期間の半分以上が費やされるケースが少なくない。評価指標を1つ誤ると、システムは“ルール上は完璧だが現実には使い物にならない珍妙な解”を量産してしまう。
- 突然変異率のチューニング地獄:変異率が低すぎると進化が頭打ちになり、高すぎると単なるランダム探索に成り下がる。この塩梅を見極める職人的な試行錯誤が不可欠となる。
【Pythonで動かす】最小構成の実装イメージとアルゴリズムの挙動
遺伝的アルゴリズムは、外部の高度なAIフレームワークに依存せずとも、標準的なPythonコードで素早く構築できる点も大きな魅力です。実務ではDEAP (Distributed Evolutionary Algorithms in Python)やPyGADといった専用ライブラリが利用されますが、基本的なロジックはシンプルなリスト操作と乱数処理で完結します。
例えば、「指定した目標文字列をランダムな文字列群から進化させて一致させる」最小構成のコードフローは以下の通りです。
import random TARGET ="OPTIMIZATION_2026" GENES ="ABCDEFGHIJKLMNOPQRSTUVWXYZ_0123456789" POP_SIZE = 100 MUTATION_RATE = 0.01 def get_fitness(individual): return sum(1 for ind, tar in zip(individual, TARGET) if ind == tar) def mutate(individual): # 突然変異処理 return [c if random.random() > MUTATION_RATE else random.choice(GENES) for c in individual] # 個体群の生成から選択・交叉・変異のループを回すことで、 # 初期世代のランダムな文字列が、数十世代後には一寸の狂いもなく TARGET へと収束する。 このように、アルゴリズムの骨格そのものは非常に簡潔でありながら、複雑怪奇な組み合わせ最適化問題に対して強烈な突破力を発揮します。
一般に知られていない盲点とネットの誤解
ネット上の技術解説やSNSでは「GAはどんな難問でも魔法のように解いてくれる万能アルゴリズム」と誤認されがちですが、実態は異なります。プロの視点から、GAを採用する前に直視すべき3つの盲点を整理します。
第一の誤解は、「常に100点満点の理論的最適解(大域的最適解)が得られる」という思い込みです。GAが提供するのは、あくまで膨大な空間から見つけ出した「極めて優秀な妥協解(準最適解)」です。絶対に1円・1ミリの誤差も許されない厳密解が必要な場面では、整数計画法などの厳密解法を選択しなければなりません。
第二の盲点は、評価関数の計算コストです。遺伝子を評価するために物理シミュレーションや3Dレンダリングを回す場合、1個体の評価に数秒かかると、1000世代×100個体で数日間マシンが拘束されることになります。計算負荷の重い領域では、代理モデル(サロゲートモデル)を噛ませるなどのアーキテクチャ設計が必須です。
【プロの結論】おすすめできる人・見送るべき人の特徴
- 遺伝的アルゴリズムを採用すべきケース:
- 配送ルート、シフト作成、ポートフォリオ最適化など、制約が入り乱れる組み合わせ問題。
- 関数の数式化が困難で、勾配(微分)情報が得られないブラックボックスな現象のパラメータ調整。
- AIモデルのハイパーパラメータ探索やニューラルネットワークの構造自動設計(NAS)。
- 他の手法を選ぶべき(見送るべき)ケース:
- 数学的に微分可能で、勾配降下法や凸最適化が素直に適用できる線形問題。
- リアルタイムにミリ秒単位で厳密な解を出力し続けなければならない組み込み制御システム。
【遺伝的アルゴリズム】に関するよくある質問(FAQ)
Q1:遺伝的アルゴリズムはプログラミング初心者でも実装できますか?
A1:はい、十分に可能です。アルゴリズム自体の基本構造は「乱数生成」「リストの分割と結合(交叉)」「条件分岐」のみで構成されているため、Pythonの初歩的な文法を理解していれば、数十行のコードで自作・動作検証が可能です。
Q2:遺伝的アルゴリズムと強化学習はどちらが優れていますか?
A2:優劣ではなく、解くべき対象が異なります。強化学習は「環境と相互作用しながら行動方針(方策)を逐次学習する」のに向いており、ゲームの操作やロボットアーム制御が得意です。一方、GAは「静的な条件が複雑に絡み合うパラメータのベストな組み合わせを一括探索する」用途に適しています。
Q3:なぜ今、ディープラーニング全盛期にGAが再び注目されているのですか?
A3:大規模言語モデル(LLM)や深層学習モデルが巨大化・複雑化し、人間の手によるハイパーパラメータ調整やプロンプトの最適化が限界を迎えているためです。AI自身を最適化するための「メタAI」として、勾配不要でロバストなGAの価値が再評価されています。
まとめ:今後の動向と失敗しないための判断基準
遺伝的アルゴリズムは、半世紀以上の歴史を持ちながら、AI全盛の時代においてその真価をさらに高めている稀有な手法です。データドリブンな予測を得意とする機械学習と、広大な空間から革新的な解を掘り起こすGAを融合させた「ハイブリッド型最適化」は、今後のシステム開発における中核技術となります。
手法の特性――「何ができて、何が苦手なのか」を冷徹に見極め、評価関数の適切な設計とパラメータ管理を行うことこそが、最適解を手に入れるための唯一の近道です。 (出典: 遺伝 的 アルゴリズム(Yahoo!ニュース))


情報を整理して届けることが得意なWebディレクター。ユーザー視点に立った記事作成を目指しています。