決定係数(R2)とは?目安や計算式・相関係数との違いを徹底解説
ビジネスの現場やデータ分析において、売上予測やマーケティング施策の効果検証を行う際に必ずと言っていいほど登場する指標が「決定係数(R²)」です。エクセルや分析ツールで回帰分析を実行すると瞬時に算出されますが、「0.7以上あれば安心なのか」「相関係数とは何が違うのか」といった疑問を抱えたまま使っているケースは少なくありません。
機械学習モデルや統計分析が日常業務に溶け込んだ現在でも、決定係数の本質を正しく理解していないと、過学習(オーバーフィッティング)を見落としたり、誤った意思決定を下したりするリスクがあります。統計学における基本的な概念から計算の仕組み、実務で迷いがちな判断基準まで、現場目線で深掘りして解説します。
📌 【この記事の重要ポイントまとめ】
- 要点1:決定係数($R^2$)は「モデルがデータのばらつきをどれだけ説明できているか」を表す指標で、統計学では「寄与率」とも呼ばれる。
- 要点2:単回帰分析では相関係数の2乗と一致するが、変数を増やす重回帰分析では過大評価を防ぐ「自由度調整済み決定係数」の確認が不可欠。
- 要点3:切片を固定した場合や極端に不適切なモデルではマイナス値を取ることもあり、目安となる数値は扱うデータのドメイン(自然科学、Web、社会科学)で大きく異なる。
【基礎知識】決定係数(R2)とは何か?意味と本質をわかりやすく解説
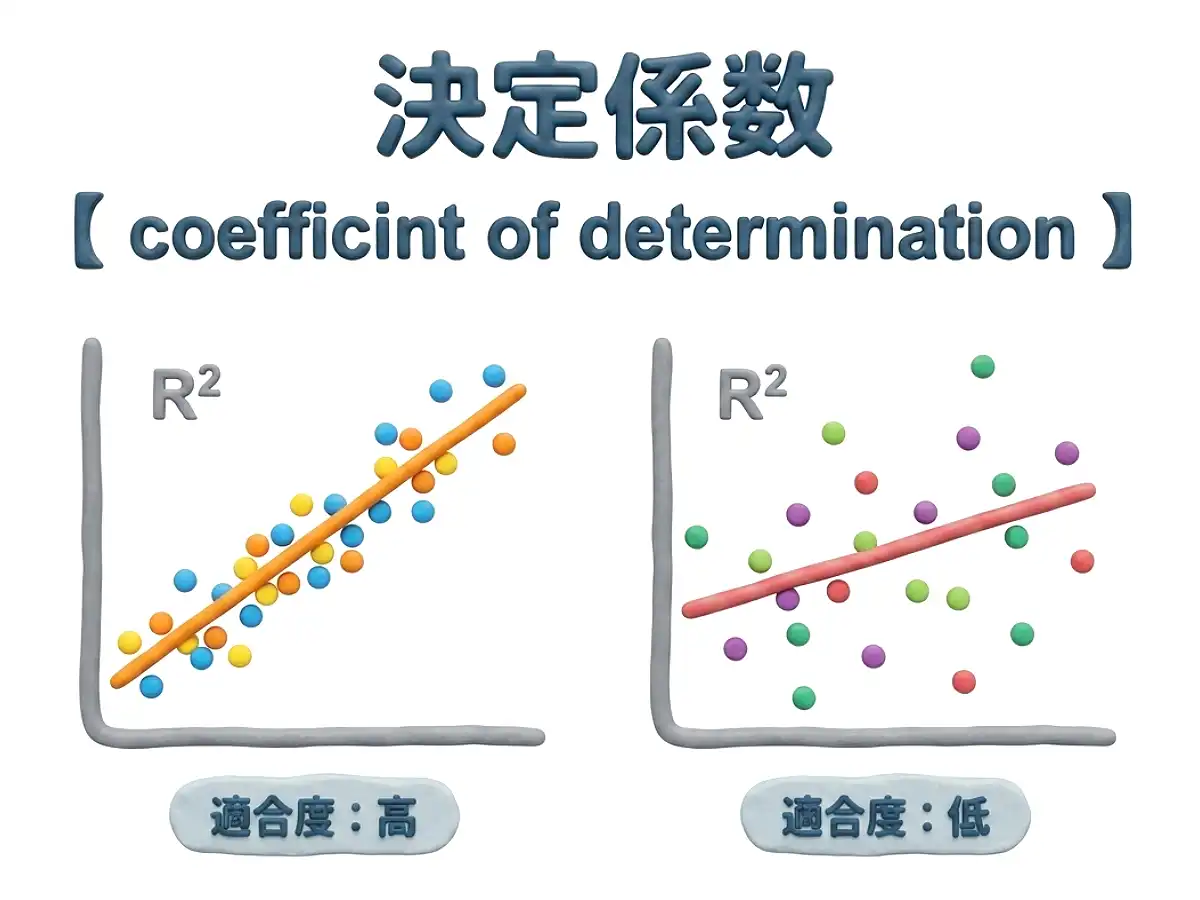
統計学や機械学習における回帰分析において、決定係数($R^2$:アール・スクエア)は、作成した予測モデルが実際のデータに対してどれくらいフィットしているかを示す「当てはまりの良さ(適合度)」を測る代表的な指標です。統計学の教科書や学術論文では寄与率と呼ばれることもあります。
通常、決定係数は0から1の間(0%〜100%)の値をとります。値が1に近ければ近いほど「目的変数のばらつきの多くを説明変数によって説明できている」状態を意味し、0に近ければ「予測モデルがほとんど役に立っていない」ことを示します。
たとえば、広告費(説明変数 $x$)から売上高(目的変数 $y$)を予測するモデルを作成し、決定係数が「0.85」だったとします。これは「売上高のばらつき(変動)のうち85%を広告費の多寡によって説明できる」という意味になります。残りの15%は、天候、競合他社の動き、季節性など、モデルに組み込まれていない他の要因によるばらつきです。
決定係数の計算式と仕組み|全変動・残差平方和から紐解く数学的ロジック
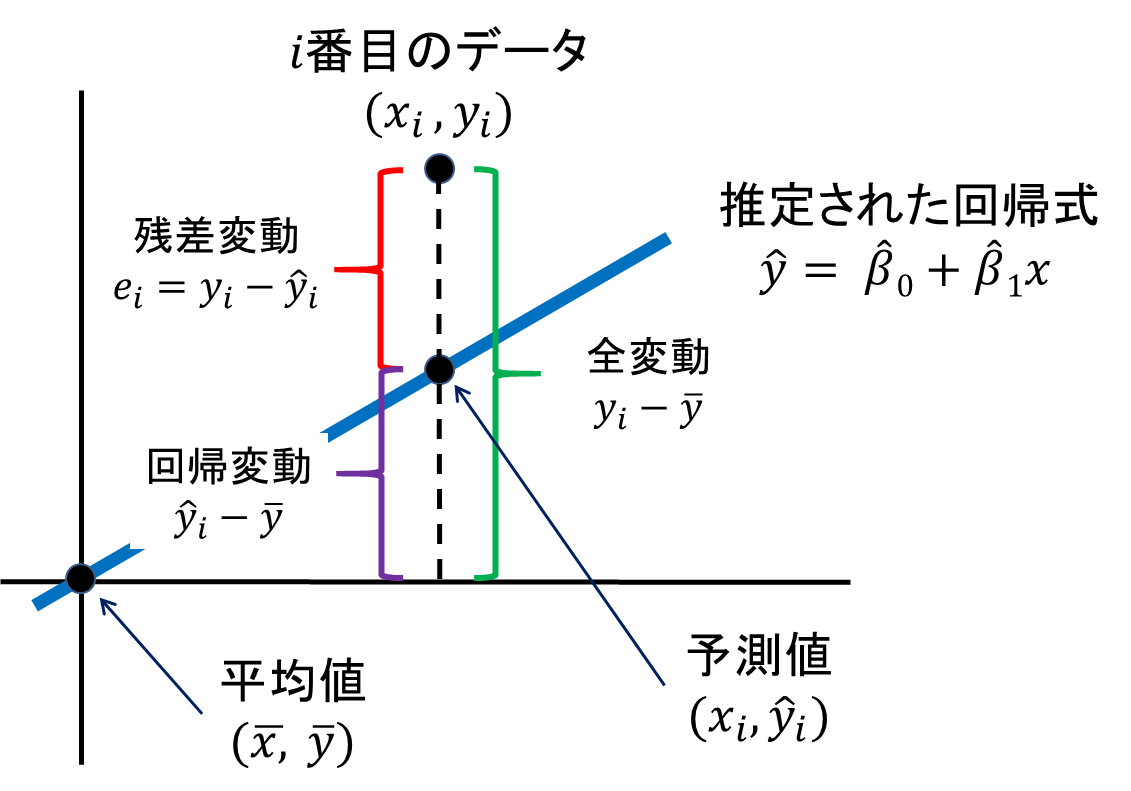
決定係数を直感だけでなく数理的に理解するには、データ全体のばらつきをどのように分解しているかを知る必要があります。基本となる決定係数の計算式は以下の通りです。
$$R^2 = 1 - \frac{\text{残差平方和(SSE)}}{\text{全変動(SST)}} = \frac{\text{回帰変動(SSR)}}{\text{全変動(SST)}}$$
ここで登場する3つの要素は、次のような意味を持っています。
- 全変動(SST: Total Sum of Squares):実際のデータが平均値からどれくらい散らばっているかを表す総量。
- 残差平方和(SSE: Sum of Squared Errors):実際のデータとモデルの予測値とのズレ(残差)を2乗して足し合わせたもの。モデルが予測しきれなかったエラーの大きさ。
- 回帰変動(SSR: Regression Sum of Squares):モデルの予測値が平均値からどれくらい離れているかを表す量。モデルが説明できた変動の大きさ。
つまり、「データ全体のばらつき(SST)のうち、モデルのエラー(SSE)を除いた割合がどれだけあるか」を計算しているのが決定係数です。予測値と実測値が完全に一致すれば残差平方和は0になり、$R^2 = 1$ となります。
なぜ決定係数がマイナスになるのか?その理由と背景
「0から1の範囲を取る」と説明されることが多い決定係数ですが、特定の条件下では決定係数がマイナス(負の値)になる現象が発生します。この現象に直面して計算ミスを疑う初学者が後を絶ちません。
決定係数がマイナスになる主な理由は、「単にデータの平均値を予測値として出力し続けるよりも、モデルの予測精度のほうが悪い」状態に陥っているためです。数式上、残差平方和(SSE)が全変動(SST)を上回ると、$1 - (\text{1より大きい値})$ となり、結果として負の数値が算出されます。
実務でこの現象が起こる典型的なパターンは以下の2つです。
- 回帰分析で「切片をゼロに固定」した場合:モデルの切片($y$切片)を強制的に0に設定すると、最小二乗法の前提が崩れ、SSEがSSTを超えるケースが生じます。
- 非線形モデルや過学習モデルの検証データ適用時:学習用データに対して過剰に適合させた複雑なモデルをテストデータに適用した際、予測が大きく外れて残差が激増し、マイナスを記録します。
相関係数との決定的な違い|単回帰と重回帰で異なる解釈の罠
分析初心者が最も混同しやすいのが相関係数($r$)と決定係数($R^2$)の違いです。両者は密接に関連していますが、扱っている概念の次元と分析の目的が根本から異なります。
説明変数が1つだけの「単回帰分析」においては、相関係数 $r$ を2乗した値が決定係数 $R^2$ と数学的に完全に一致します。たとえば相関係数が $0.8$ の場合、決定係数は $0.8^2 = 0.64$ となります。しかし、両者が示す意味合いは同一ではありません。
- 相関係数($r$):2つの変数間に「どれくらい直線的な関連性があるか」を示す指標(範囲は $-1 \le r \le 1$)。因果関係の方向性は考慮されず、対等な関係を表す。
- 決定係数($R^2$):原因となる変数から結果を「どれくらい予測・説明できているか」を示す指標(範囲は原則 $0 \le R^2 \le 1$)。因果モデルの精度を表す。
重回帰分析における「自由度調整済み決定係数」の重要性
説明変数が複数存在する重回帰分析を行う場合、通常の決定係数には重大な欠陥が生じます。それは、「目的変数と全く関係のない無意味な変数を追加しても、決定係数の値が下がらず、むしろ上昇してしまう」という数学的性質です。
たとえば、アイスクリームの売上を予測するモデルに、気温だけでなく「分析担当者の当日の歩数」や「サイコロの出目」といった無関係な変数を追加しても、通常の $R^2$ は必ず前と同等かそれ以上の値を示してしまいます。これでは不要な変数を過剰に盛り込んだ無駄なモデルを高く評価してしまいます。
この問題を解消するために使われるのが自由度調整済み決定係数(Adjusted $R^2$)です。サンプルのデータ数($n$)と説明変数の数($k$)を考慮し、無駄な変数を追加したことに対する「ペナルティ」を計算式に組み込むことで、変数の数に左右されない公平なモデル評価を可能にしています。
【分野別の目安】決定係数はいくつあれば十分か?業界別データ比較表
「決定係数は何点以上あれば良いモデルと言えるのか」という問いに対し、一律の正解は存在しません。求められる精度は、扱うデータのノイズ量やドメインの性質によって大きく異なります。
自然科学や実験室環境のように外的ノイズを厳密に制御できる領域と、人間の行動や市場心理が絡む社会科学・マーケティング領域では、評価の基準値が全く異なります。実務における一般的な目安を以下の比較表にまとめました。
| 分析対象・分野 | 決定係数($R^2$)の一般的な目安 | データの特性と背景要因 | 実務現場での評価基準・留意点 |
|---|---|---|---|
| 自然科学・物理・化学実験 | 0.90 〜 0.99 以上 | 実験環境の統制が可能で、ノイズが極めて少なく明確な数式モデルが存在する。 | 0.90未満の場合は測定機器の不具合や実験環境の不備を疑うレベル。 |
| 製造業(品質管理・機器制御) | 0.80 〜 0.95 以上 | センサーデータや設備稼働ログなど定量データが中心。精度のブレが事故に直結。 | 0.80を割ると歩留まり予測や予防保全モデルとしての実用に耐えない。 |
| Webマーケティング・広告効果 | 0.50 〜 0.70 前後 | 競合の施策、季節変動、クリエイティブの飽きなど外的要因の干渉が大きい。 | 0.60を超えれば施策の予算配分や売上予測モデルとして十分に採用圏内。 |
| 社会科学・消費者行動・心理学 | 0.20 〜 0.50 前後 | 個人の価値観や嗜好など、数値化しにくい無数の交絡因子が複雑に絡み合う。 | 0.30程度でも統計的有意性があれば「十分な示唆を持つ発見」とみなされる。 |
| 金融市場予測(株価・為替など) | 0.05 〜 0.20 以下 | 極めてノイズが多く、ランダムウォークに近い市場心理の集合体。 | 0.10でも超過リターン(アルファ)を得るためのシグナルとして極めて貴重。 |
【実態検証】利用者の生の声と現場目線で見えたリアル
データ分析が民主化され、誰もがエクセルやBIツールで簡単に決定係数を出力できるようになった一方、分析現場では数値を巡る混乱や誤解が頻発しています。実務担当者から寄せられるリアルな課題を検証します。
現場の声1:「上司から『R2が0.9以上になるまで変数を足せ』と指示された」
ビジネスの現場で頻繁に見られるのが、決定係数の高さを絶対的な正義と信じ込むマネジメント層による無理な要求です。無関係な指標まで手当たり次第に投入して通常の $R^2$ を強引に引き上げた結果、過去データには完璧にフィットするものの未来の売上は一切予測できない「過学習モデル」が完成し、施策が失敗に終わるパターンが後を絶ちません。
現場の声2:「エクセルで簡単に出せるが関数の使い分けに迷う」
エクセル(Excel)で決定係数を求める方法は主に3通り存在します。実務では作業スピードや用途に応じて使い分けが求められます。
- RSQ関数を使う:セルに
=RSQ(既知のy, 既知のx)と入力する最も手軽な方法。単回帰における決定係数を即座に出力できます。 - 散布図の近似曲線を使う:グラフ上に散布図を作成し、「近似曲線の追加」から「グラフにR-2乗値を表示する」にチェックを入れる方法。視覚的にフィット感を確認したい場合に最適です。
- データ分析ツールを使う:「データ」タブの「データ分析」から「回帰分析」を選択する方法。通常の決定係数だけでなく、「補正R2(自由度調整済み決定係数)」や各係数のP値、分散分析表まで一括で出力されます。
重回帰分析を行う場合は、RSQ関数ではなく必ずデータ分析ツールの「補正R2」を確認するのが実務における鉄則です。
一般に知られていない盲点とネットの誤解
決定係数は非常に便利である反面、単一の数値だけを過信すると致命的な分析ミスを引き起こす罠が潜んでいます。代表的な3つの盲点を取り上げます。
盲点1:外れ値が1つあるだけで決定係数は劇的に跳ね上がる
決定係数は二乗誤差をベースに計算されているため、極端な外れ値(異常値)の影響を極めて強く受けます。本来は全く無相関なデータ群であっても、右上や左下に極端に離れたデータポイントが1点存在するだけで、決定係数が0.1から0.8近くまで跳ね上がってしまう現象が起こります。決定係数の数値だけを見て安心するのではなく、必ず散布図を描いてデータの分布を目視確認することが欠かせません。
盲点2:非線形な関係性を捉えられない
通常の線形回帰における決定係数は、データが「直線的な関係」にあることを前提としています。たとえば、気温とビールの売上のように「一定の気温までは緩やかに伸び、ある温度を超えると爆発的に売れる」といったU字型や指数関数的な関係を持つデータに対して無理に直線モデルを当てはめると、決定係数は非常に低い値になります。関係性が存在しないのではなく、「直線の関係ではない」だけである点に注意が必要です。
盲点3:内生性と交絡因子の存在を無視してしまう
高い決定係数が得られたとしても、それが「説明変数によって目的変数が直接引き起こされた(因果関係)」ことを証明するわけではありません。両者に共通して影響を与えている第三の要因(交絡因子)が存在する疑似相関の場合でも、決定係数は高い数値を示します。
【プロの結論】決定係数を重視すべきケース・過信を避けるべきケース
分析の現場において、決定係数をどう評価軸に組み込むべきか、その判断基準を整理しました。
- 決定係数を信頼してモデル改善に活用すべきケース:
- サンプルのデータ量が十分に確保されており、外れ値のクレンジングが済んでいる。
- 説明変数の選定理由が論理的・ドメイン知識に基づいており、多重共線性(マルチコ)が発生していない。
- 重回帰分析において、通常の決定係数ではなく自由度調整済み決定係数を指標にしている。
- 決定係数の数値を鵜呑みにせず疑うべきケース:
- サンプルサイズが極端に少なく、変数の数だけをやたらと増やしている。
- 時系列データにおいて見せかけの回帰(単位根過程)が発生している可能性がある。
- 決定係数が0.98など不自然に高すぎる(目的変数を加工しただけの変数が混入しているリーケージの疑い)。
【決定係数とは】に関するよくある質問(FAQ)
Q1:決定係数が0.99など非常に高い値が出ました。このモデルは完璧と言えますか?
A1:過学習やデータリーケージ(正解データが説明変数に紛れ込む現象)を疑う必要があります。特に時系列データやサンプル数が少ないデータでは、偶然の適合や見せかけの相関によって異常に高い数値が出ることがあります。テストデータでの検証や残差の正規性プロットを必ず確認してください。
Q2:決定係数とP値(有意確率)はどちらを優先して見るべきですか?
A2:両者は役割が異なるため、併せて確認する必要があります。P値は「その説明変数が目的に対して統計的に意味があるか(たまたまではないか)」を示し、決定係数は「モデル全体でデータのばらつきをどれだけ説明できているか」を示します。P値で各変数の有効性を確認した上で、モデル全体の評価として決定係数を用います。
Q3:単回帰分析で決定係数がマイナスになることはありますか?
A3:通常の最小二乗法(OLS)で切片を含めて回帰直線を引いた場合、数学的に決定係数がマイナスになることはありません(必ず0以上になります)。ただし、切片を0に固定するオプションを選択した場合や、非線形なフィッティングを行った場合には、単回帰であってもマイナスの値を取ることがあります。
まとめ:決定係数を正しく使いこなしデータ分析の精度を高めよう
決定係数($R^2$)は、回帰モデルの当てはまりの良さを直感的に把握できる非常に優れた指標です。しかし、単に「1に近いから良いモデル」「0.5以下だから使えない」と短絡的に切り捨てるのではなく、その計算背景や業界ごとの基準、データの性質を多角的に見極める姿勢が不可欠です。
重回帰分析を扱う際は必ず自由度調整済み決定係数を確認し、散布図による外れ値のチェックや残差分析とセットで運用することが、信頼性の高いデータ分析を実現するための確実なステップとなります。 (出典: 決定 係数 と は(Yahoo!ニュース))

Webメディアの編集およびコンテンツ作成に従事。正確で質の高い情報発信を心掛けています。